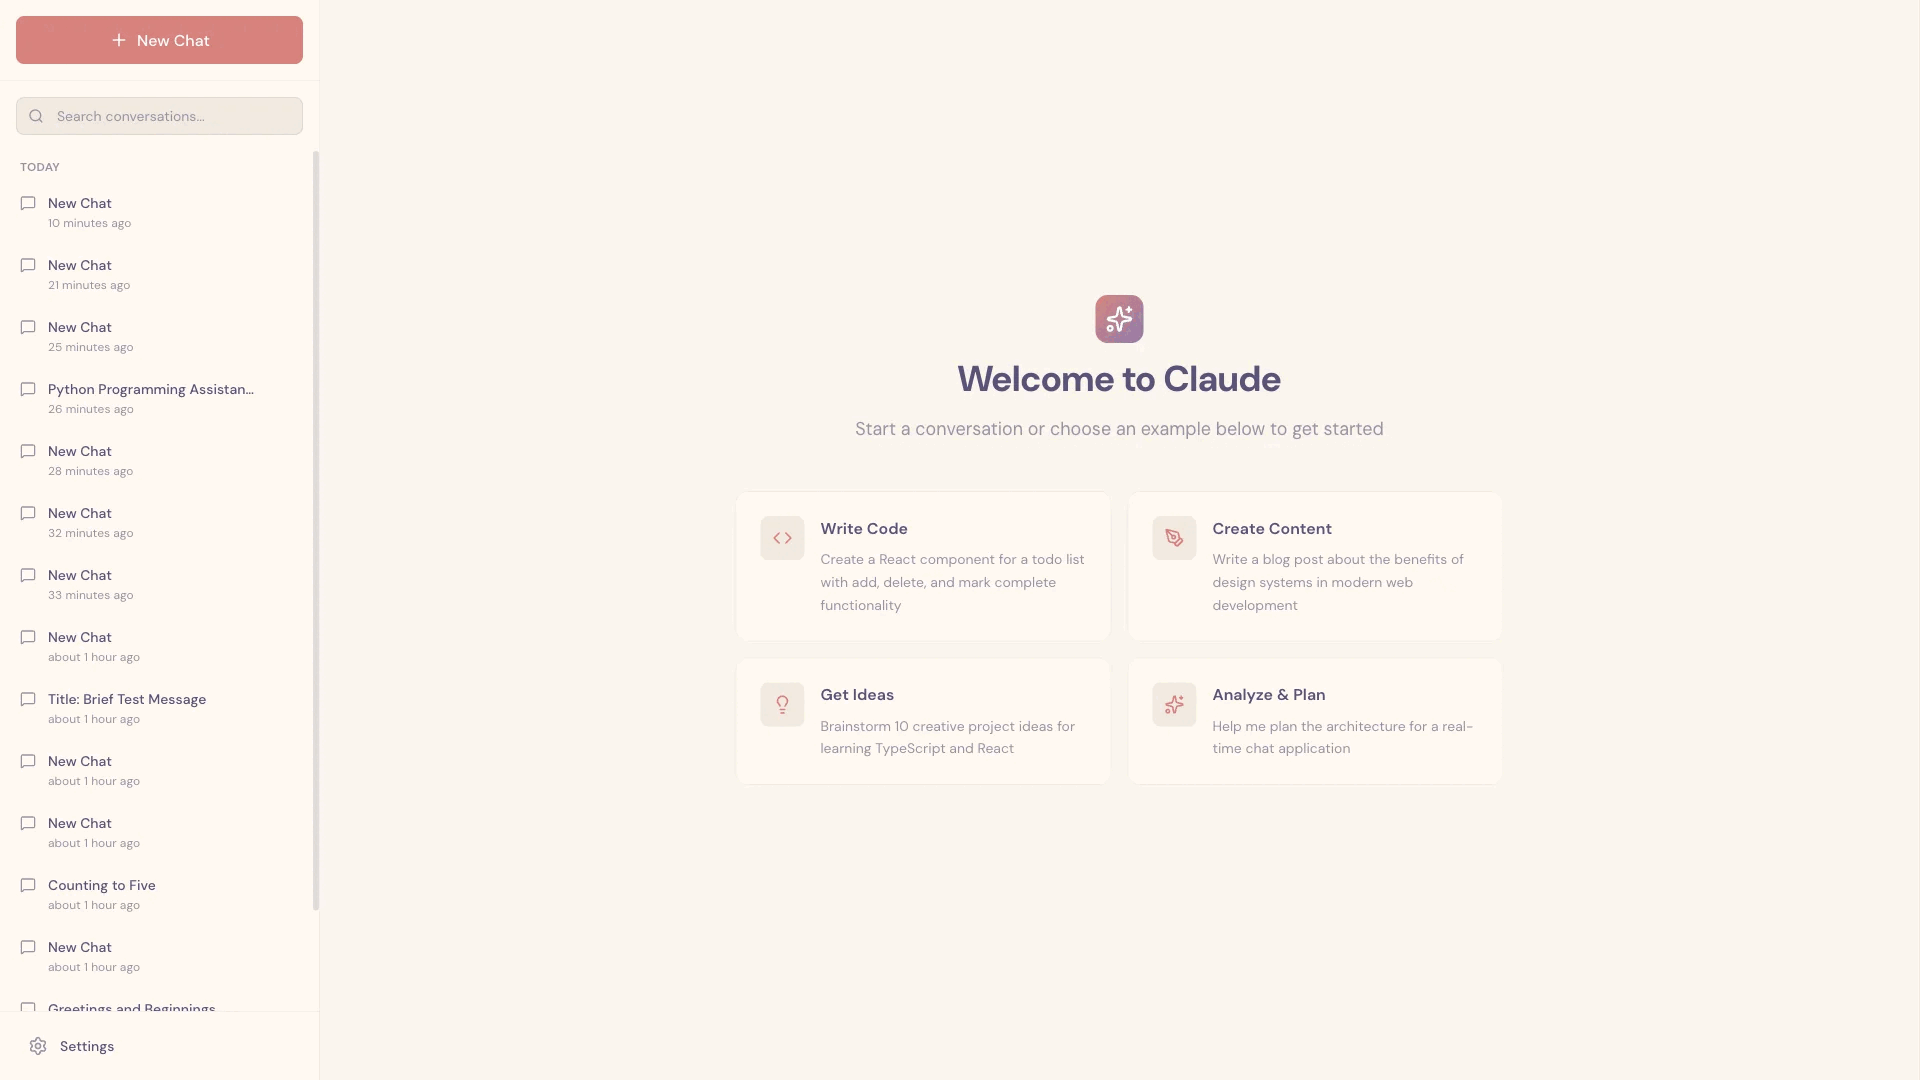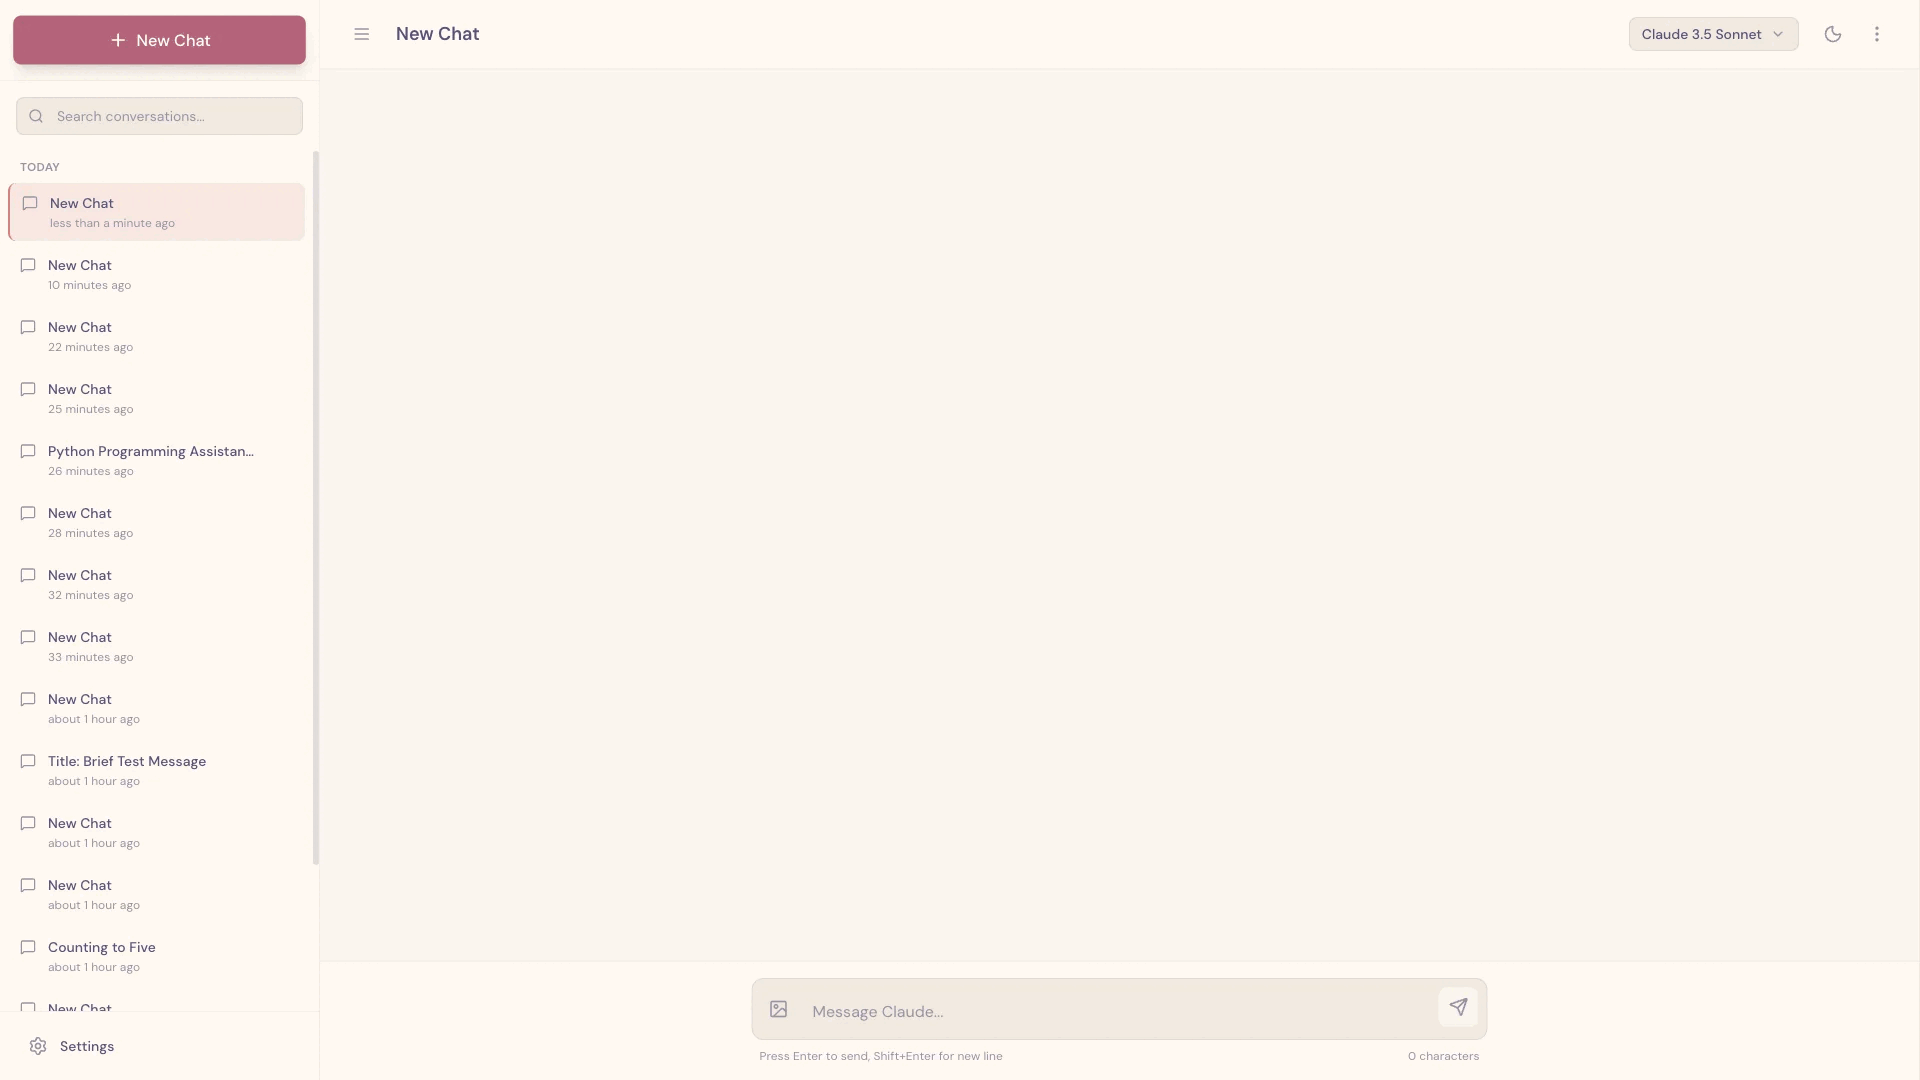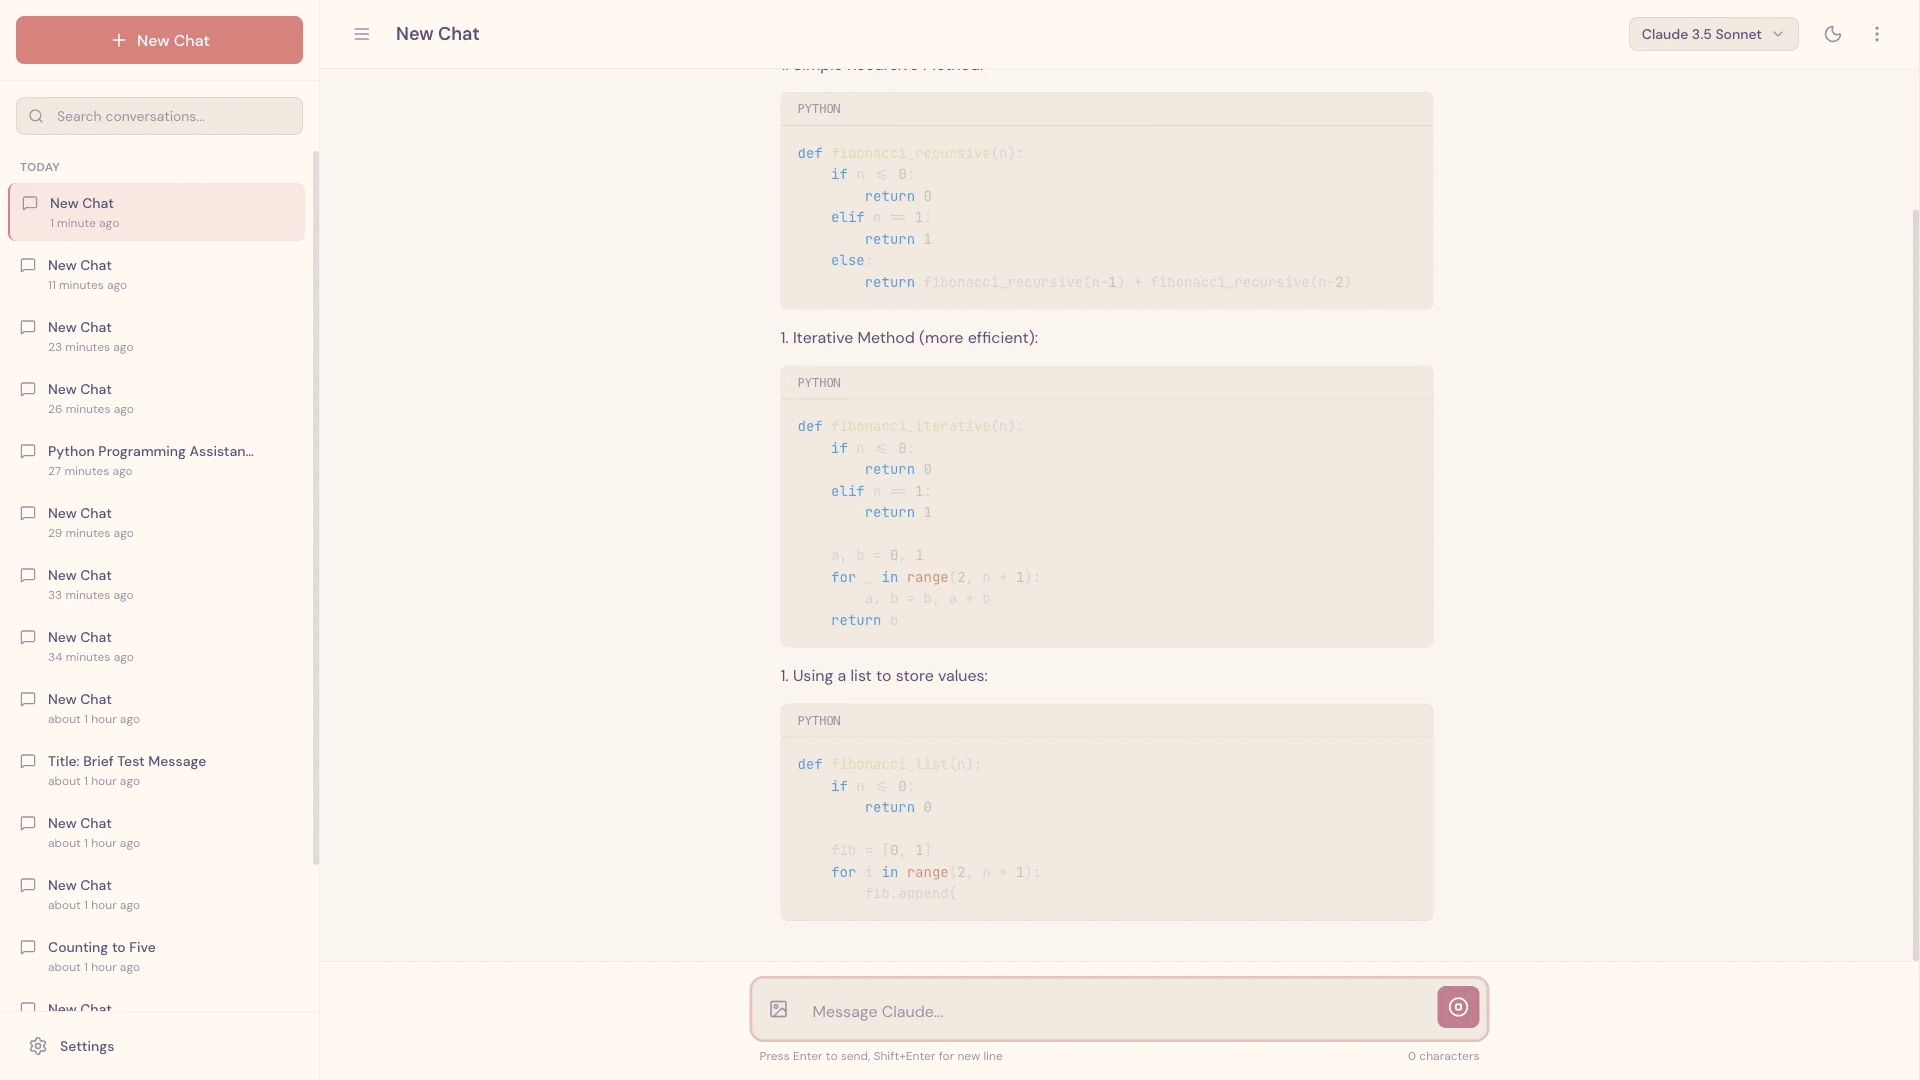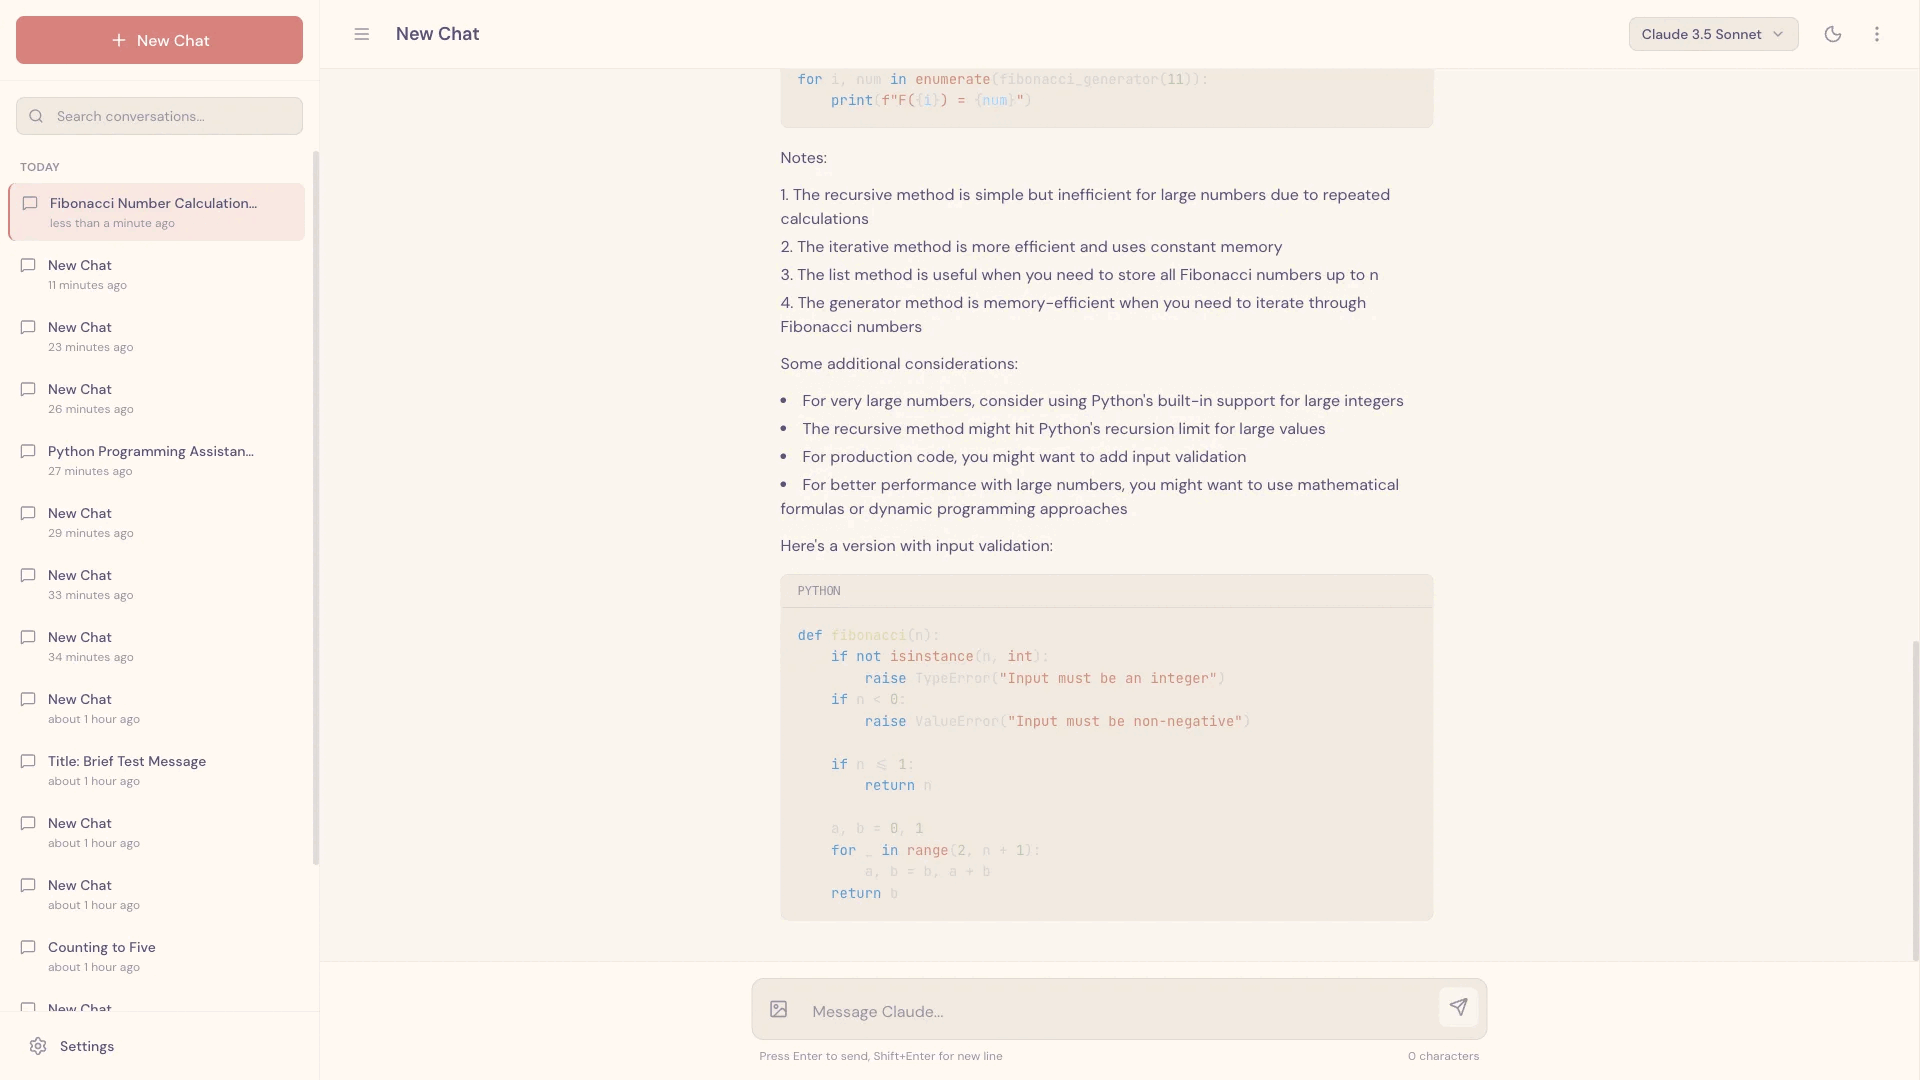
 MCP 测试 claude.ai 克隆时截下的屏幕画面" />
Effective harnesses for long-running agents · 中文翻译
原文发布:2025-11-26 · 中文译稿:2026-05-14
原文链接:anthropic.com/engineering/effective-harnesses-for-long-running-agents
本文为社区学习用途的非官方中文翻译。技术名词以括注英文原文为准;最终解释以英文原文为准。
随着 AI agent 能力越来越强,开发者越来越倾向于把那些需要数小时甚至数天才能完成的复杂任务交给它们。然而,让 agent 在跨多个上下文窗口的工作中保持稳定推进,至今仍是一个开放问题。
长时程 agent 的核心难题在于:它们必须在一段段离散的会话里工作,而每一段新会话开始时,对此前发生的一切都没有记忆。想象一个软件项目由轮班工程师负责,每位新班次工程师上岗时对上一班发生了什么一无所知。由于上下文窗口有限、而大多数复杂项目又装不进单次窗口,agent 需要某种机制在编码会话之间架起桥梁。
我们开发了一套两段式方案,让 Claude Agent SDK 能跨多个上下文窗口高效工作:一个初始化 agent(initializer agent)负责在首次运行时搭建环境,另一个编码 agent(coding agent)则负责在每次会话中做出增量推进,并为下一次会话留下清晰的工作产物。完整代码示例见配套的 quickstart。
Claude Agent SDK 是一个通用、强大的 agent harness——擅长编码,也胜任其他需要模型调用工具收集上下文、规划、执行的任务。它具备压缩(compaction)等上下文管理能力,能让 agent 在不耗尽上下文窗口的情况下继续工作。理论上,凭这套设置,agent 应该能任意长时间地持续做有用功。
但仅有压缩是不够的。即便是 Opus 4.5 这种前沿编码模型,开箱即用地在 Claude Agent SDK 上跨多个上下文窗口循环运行,仅靠一句高层 prompt(如"做一个 claude.ai 的克隆"),也无法构建出生产级质量的 web 应用。
Claude 的失败主要表现为两种模式:
第一,agent 倾向于一次做太多事——本质上是想"一把梭"把整个 app 一次性做出来。结果常常是模型在实现到一半时把上下文耗尽,留给下一次会话的是一个未完成、未文档化、状态半残的功能。下一个 agent 不得不去猜上一轮发生了什么,花大量时间把基本的 app 重新跑起来。即便开启了压缩,这种情况也会发生——压缩并不总能把指令完美清晰地传递给下一个 agent。
第二种失败模式经常发生在项目较晚期:当一部分功能已经做好后,后来的 agent 实例环顾四周,看到"已经有进展了",就宣布任务完成。
这把问题分解成两部分。第一,我们需要搭建一个能承载某个 prompt 所需全部功能的初始环境,让 agent 能逐步、按功能推进。第二,我们应当 prompt 每个 agent 在向目标推进的同时,会话结束时把环境留在一个干净状态。所谓"干净状态"是指适合合入主分支的代码:没有重大 bug、代码整齐且有文档,开发者可以直接开始新功能开发,而不必先收拾上一个 agent 留下的烂摊子。
在内部实验中,我们用一套两段式方案解决了这些问题:
init.sh 脚本、一个记录 agent 已做过哪些事的 claude-progress.txt 文件,以及一次显示新添加文件的初始 git commit。这里的关键洞见是:找到一种方式让 agent 在拿到新的、干净的上下文窗口时,能迅速理解当前工作状态——靠的就是 claude-progress.txt 文件加上 git 历史。这些做法的灵感来自高效软件工程师每天的工作习惯。
在更新版的 Claude 4 提示词指南 中,我们分享过多上下文窗口工作流的一些最佳实践,包括一种 harness 结构——"给最开始的那个上下文窗口一份不同的 prompt"。这份"不同的 prompt"要求初始化 agent 搭建好后续编码 agent 所需的全部环境与上下文。下面对这种环境的几个关键组件做深入讨论。
为了解决"一把梭做完整个 app"和"过早宣布项目完成"两个问题,我们让初始化 agent 基于用户最初的 prompt,写一份详尽的功能需求文件。在 claude.ai 克隆这个例子里,这意味着 200+ 条功能,比如"用户可以打开新聊天、输入 query、按下回车、看到 AI 回复"。所有这些功能一开始都被标记为 "failing",这样后续编码 agent 就有了一份完整功能长什么样的清晰提纲。
{
    "category": "functional",
    "description": "New chat button creates a fresh conversation",
    "steps": [
      "Navigate to main interface",
      "Click the 'New Chat' button",
      "Verify a new conversation is created",
      "Check that chat area shows welcome state",
      "Verify conversation appears in sidebar"
    ],
    "passes": false
  }
我们让编码 agent 只能通过修改 passes 字段的状态来编辑这个文件,并用措辞强硬的指令——比如"删除或编辑测试是不可接受的,因为这可能导致功能缺失或带 bug"。经过若干实验,我们最终选用 JSON 格式:相比 Markdown,模型更不容易不当地修改或覆盖 JSON 文件。
有了上述初始环境脚手架,下一阶段的编码 agent 被要求一次只做一个功能。这种增量做法对抑制 agent 一次做太多事的倾向至关重要。
仅仅做到增量推进还不够:每次代码改动后,模型必须把环境留在干净状态。我们在实验中发现,最能稳定激发这种行为的方式是:要求模型把进展用清晰的 commit message 提交到 git,并在 progress 文件里写下进展摘要。这样模型就可以用 git 回滚有问题的代码改动,恢复代码库的可用状态。
这些做法同时提升了效率,因为 agent 不再需要花时间去猜上轮发生了什么、不再需要重复把基本的 app 重新跑通。
我们观察到的另一个重要失败模式是:Claude 倾向于在没有充分测试的情况下就把功能标记为完成。如果没有显式 prompt 引导,Claude 通常会改代码、甚至用单元测试或 curl 打开发服务器做测试,但仍然意识不到这个功能从端到端来看其实没跑通。
在构建 web app 这个场景里,一旦显式 prompt 要求 Claude 使用浏览器自动化工具、以人类用户的方式做全部测试,它在端到端验证功能上的表现就大幅改善。
MCP 测试 claude.ai 克隆时截下的屏幕画面" />
把这类测试工具交给 Claude 大幅提升了表现——agent 能识别并修复那些仅看代码不容易发现的 bug。
不过仍有一些问题:Claude 的视觉能力和浏览器自动化工具本身的局限,让它难以识别所有种类的 bug。比如 Claude 通过 Puppeteer MCP 看不到浏览器原生的 alert modal,依赖这类 modal 的功能因此更容易带 bug。
上述基础设施就位后,每个编码 agent 都被 prompt 去走一套"找方向"的步骤——有些非常基本,但确实有用:
pwd 看看你当前在哪个目录。你只能编辑这个目录里的文件。这种做法每次会话都能为 Claude 省下一些 token——它不再需要从头琢磨"该怎么测试这段代码"。同时也很有用的是:让初始化 agent 顺手写一个 init.sh 脚本能起动开发服务器,并在开始新功能之前先跑一遍基本的端到端测试。
在 claude.ai 克隆这个例子里,这意味着 agent 总是会先启动本地开发服务器,用 Puppeteer MCP 开一个新聊天、发一条消息、收到回复。这样 Claude 能第一时间发现 app 是否处在损坏状态、并立即修复已存在的 bug。如果不这么做,直接动手做新功能,反而会让问题变得更糟。
基于以上设置,一次典型会话会以这样的 assistant 消息开始:
[Assistant] I'll start by getting my bearings and understanding the current state of the project.
[Tool Use] <bash - pwd>
[Tool Use] <read - claude-progress.txt>
[Tool Use] <read - feature_list.json>
[Assistant] Let me check the git log to see recent work.
[Tool Use] <bash - git log --oneline -20>
[Assistant] Now let me check if there's an init.sh script to restart the servers.
<Starts the development server>
[Assistant] Excellent! Now let me navigate to the application and verify that some fundamental features are still working.
<Tests basic functionality>
[Assistant] Based on my verification testing, I can see that the fundamental functionality is working well. The core chat features, theme switching, conversation loading, and error handling are all functioning correctly. Now let me review the tests.json file more comprehensively to understand what needs to be implemented next.
<Starts work on a new feature>| 问题 | 初始化 Agent 的动作 | 编码 Agent 的动作 |
|---|---|---|
| Claude 过早宣布整个项目已完成。 | 搭建一份功能清单文件:基于输入规格,生成一份结构化 JSON,列出端到端的功能描述。 | 会话开始时读取功能清单文件,只选一个功能开始工作。 |
| Claude 把环境留在带 bug 或未文档化的进展状态。 | 写入一个初始 git 仓库和 progress 笔记文件。 | 会话开始时读 progress 笔记和 git commit 日志,并在开发服务器上跑基本测试以发现未文档化的 bug;会话结束时写入一次 git commit 和 progress 更新。 |
| Claude 过早把功能标记为已完成。 | 搭建功能清单文件。 | 自验证所有功能;只有经过细致测试之后才把功能标记为 "passing"。 |
| Claude 要花时间琢磨怎么把 app 跑起来。 | 写一个能启动开发服务器的 init.sh 脚本。 |
会话开始时先读 init.sh。 |
本研究展示了一种可能的"长时程 agent harness"方案,让模型能跨多个上下文窗口做出增量推进。但仍有不少开放问题。
最值得探讨的是:单一通用编码 agent 跨上下文表现最好,还是采用多 agent 架构能取得更优表现,目前还不清楚。可以合理推测:像测试 agent、QA agent、代码清理 agent 这样的专门 agent,可能在软件开发生命周期的各类子任务上做得更好。
此外,本 demo 是为全栈 web 应用开发而优化的。一个未来方向是把这些发现推广到其他领域——本文的某些或全部经验,很可能能应用到比如科学研究、金融建模等其他需要长时程 agentic 工作的场景中。
由 Justin Young 撰写。特别感谢 David Hershey、Prithvi Rajasakeran、Jeremy Hadfield、Naia Bouscal、Michael Tingley、Jesse Mu、Jake Eaton、Marius Buleandara、Maggie Vo、Pedram Navid、Nadine Yasser、Alex Notov 的贡献。
本工作凝结了 Anthropic 多个团队的集体努力,让 Claude 得以安全地执行长时程的自主软件工程任务,特别感谢 code RL 团队与 Claude Code 团队。有意贡献的候选人欢迎在 anthropic.com/careers 申请。
答案中以
[术语]标记的概念都可点击跳到本表对应条目并自动展开。本表按 10 个主题分组收录 60+ 高频术语,默认全部收起——遇到不熟的术语再展开看精要解释,避免被信息淹没。
不实际运行代码的情况下分析源码,识别潜在 bug、未使用变量、风格违规、可疑用法。常见工具:
在 Agent 工程中,lint 经常被用作 harness 的硬约束——把 lint 错误反馈给模型重写代码,比单纯在 prompt 里说"请遵守编码规范"可靠得多(Augment Code 把这叫做 Constraint Harness)。
确保代码中变量赋值、函数调用的类型一致:
对 Agent:让 agent 写完代码后强制跑 tsc --noEmit / mypy . / cargo check,类型错误作为反馈喂回模型继续修。比让 agent 自己"声明检查过类型"可靠得多——这是 harness 工程的典型做法。
CI(Continuous Integration):每次代码提交自动跑测试、构建、lint、type check 等校验。
CD(Continuous Deployment):通过校验后自动部署到测试 / 预发 / 生产环境。
常见工具:GitHub Actions、GitLab CI、Jenkins、CircleCI、Buildkite。
在 Agent 工程里,CI 是最重要的 deterministic 反馈源——LLM 自评不可靠,但 CI 通过/失败是 0/1 信号,可以直接作为 ground truth。Hashimoto 的 harness engineering 强调"能不能解决问题强相关于 agent 能不能验证自己的工作"。
让不可信代码(用户上传、LLM 生成)在受限环境中跑,防止破坏宿主系统。隔离强度从弱到强:
Agent 跑用户/LLM 生成代码必须沙箱,并叠加纵深防御:网络出口白名单 + 文件系统只读 + 时间/内存配额 + 不挂载 host 凭据。
来自煤矿用金丝雀检测毒气的典故。部署流程典型为:shadow(双跑不返回)→ 1% → 5% → 25% → 50% → 100%,每阶段观察核心指标无回归才推进。
对 LLM 应用:新 prompt / 新模型 / 新 agent harness 上线必走 canary,关键指标(解决率、CSAT、refusal 率、p99 延迟、单次成本)任何一个恶化 > 阈值就回滚。LLM 应用的"非确定性"特性让 canary 比传统软件更重要。
按 user_id hash 切流量保证一个用户始终进同一桶(避免体验跳变)。判定要素:
LLM 应用调 prompt / 换模型 / 改 RAG 都应过 A/B;只靠 offline eval 上线常翻车(线上流量分布与黄金集差异大)。
业务侧验收 Agent 是否上线最看的几个指标:
Agent 工程关注:把模型 / prompt / RAG 改动放进 A/B 看这些业务指标,而非只看离线 benchmark 分数。改动让 benchmark 涨但 GMV / CSAT 跌的情况非常常见。
Agent 自治走到关键节点时暂停等待人工:
设计原则:"Humans steer. Agents execute."(OpenAI Harness Engineering)。Agent 不是替代人,是放大人的判断——把人放在制定计划、设定约束、审核结果的位置,agent 处理执行。
Google SRE 体系定义的四个术语:
1 - SLO。SLO 99.9% 意味着 30 天有 43.2 分钟"预算"可以不达标,预算用完就冻结非必要发布。Agent 应用怎么用:
经验法则:SLO 不是越严越好——99.99% 比 99.9% 贵 5-10 倍,且大概率超过用户感知阈值。Google 建议"刚刚够用户不抱怨"的水位。
到期自动失效。常见用法:
经验换算:1000 英文单词 ≈ 1300 token;1000 汉字 ≈ 1500-2000 token。
为什么重要:context window、API 计费、推理速度都按 token 算。控制 token 数 = 控制成本和延迟。Anthropic / OpenAI / Google 各自的 tokenizer 不同,相同文本 token 数差 ±20% 很常见。
文本 → 神经网络 → 一个 768 / 1024 / 1536 / 3072 维的浮点数向量。同义词 / 同主题文本的向量在空间中距离近(cosine similarity 高)。
主要用途:
主流模型 2026:OpenAI text-embedding-3-large、Cohere v4、Voyage-3、BGE-M3(开源 SOTA,中英双语 + dense/sparse/multi-vector 三合一)。
包含 system prompt + 历史对话 + 用户输入 + 模型输出,所有都计算在内。2026 主流模型:
注意:宣称窗口 ≠ 有效窗口。RULER 基准显示多数模型在窗口 1/4 之外性能急剧下降(Lost in the Middle)。工程建议把"应当塞入 context"的阈值定在 8-32k,更长走 RAG 或层级摘要。
两个阶段瓶颈不同,调优策略也不同——prefill 优化靠并行 / FlashAttention,decode 优化靠 continuous batching / speculative decoding。
生成第 t 个 token 时需要前面所有 token 的 K/V 参与注意力计算。把它们缓存下来避免每次重算,是 LLM 推理的最基础优化。
显存占用:2 × num_layers × num_heads × head_dim × seq_len × batch × bytes_per_elem。70B 模型上 128k 上下文的 KV cache 可达数十 GB,远超模型权重本身。
进阶优化:
GPT 类 decoder-only 模型的生成方式:P(x_t | x_1, ..., x_{t-1})。每生成一个 token 都要跑一次完整 forward(虽然能复用 KV cache),所以输出长度直接决定延迟。
对比:BERT 是非自回归(masked LM,一次预测所有 mask 位置),扩散模型(diffusion)也是非自回归(一次去噪整段)。
自回归的代价催生了大量加速技术:speculative decoding、parallel decoding、Medusa、EAGLE 等。
decoder 最后一层输出 [vocab_size] 维的 logit 向量;过 softmax 后得到下一个 token 的概率分布。
工程上能拿到 logit(或 top-k logprob)的场景:
注意:OpenAI / Anthropic 商用 API 默认只返回采样结果,需显式开 logprobs 选项。
P(token) ∝ exp(logit / T):
何时调高:Self-Consistency 需要多样路径、creative writing、brainstorm。
何时调低:代码生成、数学推理、严格格式输出,T=0.1-0.3。
陷阱:T=0 不完全等同 deterministic——浮点 GPU 算子的非确定性 + 并发调度可能让相同 prompt 的输出仍有微差。
Xiao et al. 2023 发现:长序列推理时,靠后的 token 往往把不成比例多的注意力分给了序列最前面的几个 token(即使它们语义无关)——这些 token 成为"sink",吸收掉 softmax 必须分配的归一化质量。
工程意义:
LayerNorm:y = (x - μ) / σ * g + b,沿 hidden 维度求均值方差。与 batch 无关,天然支持变长序列与单条推理——这是 Transformer 选 LayerNorm 而非 BatchNorm 的原因。
RMSNorm(Zhang & Sennrich 2019):y = x / sqrt(mean(x²)+ε) * g,去掉减均值和 bias。Llama / PaLM / Mistral 等现代 LLM 几乎都改用 RMSNorm,省 7-64% 归一化耗时且效果不降。
Pre-LN vs Post-LN:LN 在残差前做(Pre-LN)训练比放残差后(Post-LN)稳定,可去掉 warmup,GPT-2 起几乎统一用 Pre-LN。
Su et al. 2021。把位置 m 表示为旋转矩阵 R_m 作用在 Q/K 上,使得 <R_m·q, R_n·k> = f(q, k, m-n)——注意力得分只依赖相对距离。
优点:(1) 无额外参数;(2) 天然编码相对位置;(3) 可与线性注意力兼容。已成 Llama / Qwen / Mistral 等绝大多数现代 LLM 的位置编码方案。
外推问题:纯外推 2k→32k 会崩——高频分量旋转角度落入未见区域。缓解:
RoPE 纯外推会崩——高频分量在训练上下文外旋转角度落入未见区域。两种工程化方案:
主流应用:
经验数字:YaRN 在 4× 上下文扩展(2k→8k 或 32k→128k)几乎无损;8× 以上仍有性能下降。极致长上下文(1M+)通常需要重训而非仅靠 YaRN。
标准 multi-head attention:H 个头各有独立 Q/K/V。
收益:KV cache 减小到 1/8 ~ 1/H,推理吞吐显著提升,效果几乎无损。Llama-2 70B / Llama-3 / Mistral / Qwen2 等都用 GQA。
把传统 dense FFN 换成 N 个并行的 expert FFN + 一个 router。每个 token 通过 router 选 top-k 个 expert(k 通常 1-2),只激活这部分 expert 计算。
优点:参数量大、算力省。Mixtral 8x7B 总参数 47B,激活参数仅 13B;DeepSeek-V3 671B 总参数,激活仅 37B。同等推理成本下 capacity 远超 dense 模型。
挑战:(1) 训练时负载均衡(防一两个 expert 被过度使用);(2) 显存占用按总参数计而非激活参数;(3) 通信开销大(expert parallelism)。
单头注意力对每对 token 只产生一个 attention 分布——一种"关系视角"。多头(h=8/32/64/128)让模型同时学多种关系——句法头关注短距离依赖,语义头关注共指、远程实体。
为什么单头加大维度不行:多头是 h 个低秩注意力的混合,表达能力严格更强;单头是一个高秩注意力,自由度反而少。
进阶变体:GQA / MQA 在 KV 侧减头省显存,Q 侧仍保多头。
Dao 2022。标准 attention 显存 O(N²)(要存 N×N 的 attention matrix),长序列瓶颈。FlashAttention 把 Q/K/V 分块加载到 GPU SRAM 计算,不写出完整 attention matrix,显存降到 O(N),速度也快——attention 是 memory-bound,少读 HBM 就快。
演进:
Kwon et al. 2023。解决传统推理 KV cache 的三类碎片问题:
机制:KV cache 切成固定大小 block(如 16 token),每个序列维护 block table(逻辑→物理映射)。显存利用率从 ~20% 提到 >96%;同 prompt 多采样共享前缀 block;配合 continuous batching 吞吐相对 HuggingFace TGI 提升 2-4×,相对 FasterTransformer 24×。
2023 年起的事实标准开源推理服务器。核心特性:
对比:TGI(HuggingFace)、TensorRT-LLM(NVIDIA,私有更快)、SGLang(前缀复用更彻底)、LMDeploy(OpenCompass 出品)。
也叫 in-flight batching,Yu et al. ORCA 2022 提出。对比 static batching(等齐 batch 再一起跑,长短请求混在一起时 GPU 利用率经常 <30%),continuous batching:
vLLM 数据:吞吐相比 static 提升 5-23×。已成所有现代推理引擎的默认。
Leviathan et al. 2023。流程:
数学上保证输出分布与原模型完全一致(rejection sampling)。
收益条件:(1) draft 与 target 分布相似(接受率 >60%);(2) 大模型受 memory bandwidth 限制,并行验证不增延迟。代码生成接受率 70-90%,开放生成 30-50%。变体:EAGLE-2/3、Medusa、Llama 3.1 self-speculative。
KV cache 是单 request 内复用;prefix caching 是跨 request 复用——多个 request 共享 system prompt / few-shot / agent 历史时,首次计算后缓存这部分 KV,后续 request 直接命中跳过 prefill。
效果:agent / RAG / 多轮对话场景,system prompt 通常 1-4k token、几乎所有请求共享,TTFT 可下降 10-100×。
实现:vLLM --enable-prefix-caching、SGLang RadixAttention(用 radix tree 自动管理所有历史前缀)、Anthropic prompt caching API(5min TTL,cached 部分 0.1× 价格)。
主要由 prefill 决定(处理 input 所有 token)。计费、监控的核心指标之一。
降低 TTFT 的手段:
伴生指标:TBT(time between tokens,单 token 间隔)— 由 decode 决定。
混合精度训练:权重和梯度用 BF16/FP16,optimizer state 仍用 FP32。
部署阶段把权重量化到低 bit 整数,推理时反量化回浮点计算。
INT8 / INT4 量化通常需要校准集(128-512 样本),AWQ 更智能(保护 1% salient 通道)。极致显存场景再用 GGUF(llama.cpp 格式)+ 3-bit / 2-bit 量化跑手机端。
Lin et al. 2023。核心洞察:只需保护 ~1% 的"重要权重通道"(由激活幅值识别)即可保住精度。对这些通道按 per-channel scale 放大再量化。
对比 GPTQ:实现更简单,Llama-2 上困惑度更低,已成 vLLM / TensorRT-LLM 默认。
Frantar 2022。用 OBQ 启发的逐层最小化量化误差,需要少量校准集(128 样本)。优点:早、生态全(exllama / vllm / TGI 都支持);缺点:对激活分布敏感,重要通道可能被压坏。
2026 部署选型:H100/H200 → FP8;A100/3090 → AWQ INT4;手机/边缘 → INT4 + GGUF。
最基础的指令微调方式:把 (输入, 期望输出) 对当做监督学习样本,cross-entropy loss 教模型学指令跟随。
经验数据量:
LIMA 论文:1000 条精选样本即可让 65B base 接近 GPT-4 对话质量——质量 >> 数量。
Hu et al. 2021。把权重更新分解为两个低秩矩阵 ΔW = BA(r=8/16/64),只训练这两个矩阵,可训参数减少 100-10000×。
显存:
优点:可训参数少 / 多个 adapter 可热切换 / 缓解 灾难性遗忘。
Dettmers et al. 2023。三项关键:
65B 模型 QLoRA 约 33GB,单 A100-48G 或双 RTX 3090 可跑。代价:训练慢 30-40%(反量化开销)。
三步走:(1) SFT 训出 base policy;(2) 人类标注 (chosen, rejected) 偏好对训出 Reward Model;(3) 用 RM 给 policy 输出打分,PPO/RLOO/REINFORCE 等算法更新 policy。
InstructGPT、ChatGPT 让 RLHF 出圈。三大痛点:
RLHF 第二步训出。输入:(prompt, response),输出:一个 scalar reward。训练 loss 是 Bradley-Terry:让 RM 在 (chosen, rejected) 对上给 chosen 更高分。
常见弱点:
Rafailov et al. 2023。证明:在 Bradley-Terry 偏好模型 + KL 约束下,最优 policy 有闭式解,可直接用偏好对 (chosen, rejected) 做监督式损失:
L_DPO = -log σ(β(log π(y_w)/π_ref(y_w) - log π(y_l)/π_ref(y_l)))
优势:(1) 无 RM / 无在线采样 / 无 critic,仅 policy + ref 两个模型;(2) 用 SFT 同样的训练栈;(3) 超参稳定。
劣势:严重依赖偏好数据质量;容易过拟合 chosen 的表面模式;reward hacking 风险大。
Llama-3、Qwen2 后训练主路径都是 DPO 或其变种(IPO、KTO、SimPO)。
Schulman 2017。Actor 学策略,critic 学 value function 估计 advantage,clip 限制每步策略更新幅度防崩。
RLHF 中需同时载入 actor / ref / critic / reward 四个模型,显存 ≥4× 单模型。超参敏感(KL 系数、clip ratio、advantage 归一化),训练不稳定。
催生了 DPO(去 RL)、GRPO(去 critic)、RLOO(用平均 reward 当 baseline)等简化方案。
DeepSeek-Math 2024 提出,R1 验证。核心创新:去掉 critic(value 网络),对同一 prompt 采样 G 个 response(典型 G=64),用组内 reward 的均值/标准差做 advantage 归一化:A_i = (r_i - mean(r)) / std(r),再做 PPO-like 的 clipped objective + KL 正则。
效果:
在数学、代码、形式逻辑等可自动验证的任务上,直接用程序判定 reward:答案匹配、单测通过、定理证明器验证。
优势:
DeepSeek-R1、DAPO(ByteDance 开源 SOTA)都属此类。局限:仅适用可验证任务,开放对话仍需 RLHF / DPO。
机制:参数被新任务 loss 拉走,原本编码通用知识的方向被覆盖。
缓解组合(生产推荐):
进阶:EWC(按 Fisher 信息加权 L2 正则)、Model Souping(微调模型与原模型权重平均)、MoE 路由扩展。
Wei et al. 2022。最简形式:"Let's think step by step"(Kojima 2022 zero-shot CoT)。
为什么有效:(1) 增加有效 compute(更多 forward step);(2) 把"系统 1"直觉答题转成"系统 2"分步推理;(3) 暴露错误推理便于 self-consistency 投票纠正。
是涌现能力,<10B 模型几乎无效。Long CoT(R1 / o1 用 RL 训出,含回溯/自我验证,数千 token 长)是 2025 的新范式。
Yao et al. 2023。CoT 是线性单链,错了无法回头;ToT 每步生成多个候选 thought,LLM 自评估状态价值(promising / sure / impossible),BFS/DFS 展开可回溯剪枝。
Game of 24 上 GPT-4 CoT 4% vs ToT 74%。代价:LLM 调用数从 1 涨到 50-200。
适合:解空间需显式搜索(puzzle、规划、定理证明),中间状态可评估。不适合:闲聊、摘要、翻译。
Yao et al. 2022。结构 Thought → Action → Observation 循环:模型先 "Thought: 我需要查 X",输出 "Action: search[X]",工具结果作为 "Observation: ..." 喂回 prompt,再下一轮 Thought。
三大效果:
是现代 agent 框架(Claude tool use、OpenAI function calling、LangChain、AutoGPT)的概念原型。
Shinn et al. 2023。Agent 在一次任务失败后(由外部 verifier 给二元 reward),用 LLM 把失败原因总结成自然语言 lesson 存入 episodic memory,下一次任务时把 lesson 加进 prompt 影响行为。
vs Self-Refine:
HumanEval 上 GPT-4 Reflexion 91%,超过 GPT-4 baseline 80%。
Madaan et al. 2023。在一个 trajectory 里循环 N 轮,无外部 reward、无跨任务记忆。7 个任务平均提升 20%。
陷阱:弱模型自评不准,可能越改越差。生产常组合 Self-Refine(局内)+ Reflexion(跨局)。
Wang et al. 2022。temperature>0 采样 N 条 CoT 路径,对最终答案投票。GSM8K 上比 greedy CoT 提升 ~17 个百分点(PaLM 55%→74%)。
收益大场景:(1) 答案空间离散(数字、选择题);(2) 模型错误率 <50%;(3) 推理路径多样(temperature 0.7-1.0)。代价:N×(典型 N=5-40),开放生成不适用。
何时 few-shot:(1) 任务格式新颖/输出结构复杂(JSON schema、特定 markdown);(2) 分类任务标签多。
何时 zero-shot:通用任务现代模型已饱和(摘要、翻译、QA),加 example 反而引入偏差。
陷阱:example 顺序影响大(recency bias);偶然规律会被学走;example 多了 Lost in the Middle。建议 ≤8 条。
标准 pipeline = Ingestion + Retrieval + Generation:
每段都有瓶颈:chunking 切大小、embedding 选型、召回率不足、context 顺序、模型不忠于 context。生产 RAG ≠ "embedding + 向量库 + LLM"——是一个工程系统。
策略:
Okapi BM25。文档与 query 的相关性按 Σ IDF(qi) · f(qi,d) · (k+1) / (f + k·(1-b+b·|d|/avgdl)) 计算。强项:精确词命中、稀有词高权重、专有名词、数字。短板:同义词不通("医生" vs "doctor")。
与 dense embedding 互补——hybrid search 把两者融合,召回率比单 dense 提升 5-15 个百分点。
dense embedding 擅长语义近似,BM25 擅长精确词匹配,两者互补。
融合方法:
score(d) = Σ 1/(k + rank_i(d)),k=60。生产首选,无需归一化两路分数α·dense + (1-α)·bm25,需要调 α 且分数归一化Anthropic Contextual Retrieval 实验:单 embedding → +contextual embedding → +BM25 → +rerank,失败率 5.7% → 4.0% → 3.7% → 1.9%。
Bi-encoder(embedding):query / doc 分别编码再 cosine 比对,快但无交互。
Cross-encoder(reranker):query + doc 拼接喂 transformer,每层 self-attention 交互,相关性建模能力强 20-40%(NDCG@10),慢 100×。
生产标配:bi-encoder 召回 top-100 → cross-encoder rerank 到 top-10 → 喂 LLM。
主流:Cohere Rerank v3/v4、BGE-reranker-v2-m3(开源 SOTA 中英)、Jina Reranker v2、Mixedbread。
陷阱:召回 top-100 里没有相关文档,rerank 也救不了——reranker 锦上添花,不能替代召回。
2026 主流 embedding 模型对比:
选型框架:
关键陷阱:
主流:
ANN 算法:HNSW(最常见)、IVF、ScaNN(Google)。索引时间 vs 检索精度 vs 显存有 trade-off。
朴素 RAG 在多文档跨实体推理、召回质量不稳、多跳查询场景下都会力不从心。四个常见进阶方案:
实战选择:
Es et al. 2023。四大指标:
生产阈值:4 个指标都 ≥0.7 算合格;Faithfulness < 0.7 优先修;Context Recall < 0.7 调 retriever。
Mitchell Hashimoto 2026 命名:"anytime you find an agent makes a mistake, take the time to engineer a solution such that the agent never makes that mistake again."
不是模型微调,而是工程化环境让模型物理上无法以同样方式再犯错。
两条法则:
OpenAI 公式:Agent = Model + Harness;"Humans steer. Agents execute."
2024-2026 主流框架对比:
经验:先用 SDK 直调写原型;workflow 模式(routing / parallelization / orchestrator-workers)成熟后再考虑 LangGraph;纯 RAG 场景考虑 LlamaIndex;避免一上来就 LangChain "全家桶"。
2024-11 推出,2025-Q4 转入独立 Steering Committee(Anthropic / Block / OpenAI / Microsoft)。三种核心原语:
解决"每接一个新工具就要写一遍 adapter"的 N×M 问题。2026 年增速最快的单一技能,97M+ 月下载,已是 Anthropic Applied AI Engineer JD 显式必备。
模型输出 {"name": "search", "arguments": {"query": "..."}} JSON,runtime 解析后真实执行函数,结果回喂模型。Anthropic Tool Use API、OpenAI function calling 都是同思路。
设计原则(Anthropic 实测:"agent 性能正比于工具描述清晰度"):
Anthropic 2024-Q4 推出 Computer Use。流程:截屏 → LLM 看图 + 推理 → 输出鼠标键盘动作(click X,Y / type text / scroll)→ 系统执行 → 再截屏循环。
Browser Use(开源框架)类似但限于浏览器,基于 Playwright + DOM 增强(把可点击元素加序号叠加到截图)。
实用场景:无 API 网站自动化、桌面软件自动化、端到端 e2e 测试。局限:慢、贵、安全性差、对 canvas 渲染应用支持差。生产建议:能用 API 就别用。
主 agent 把"读 30 个文件做研究"丢给 sub-agent,sub-agent 有自己的独立 context 窗口,只把 final summary 回报给主 agent——主 context 不被中间产物污染。
Claude Code Task 工具、OpenAI Swarm、CrewAI 等都支持。是防止 Loop of Death 和 context 爆炸的关键手段之一。
Agent 进入项目时自动读取。通常包含:
Hashimoto 视角:每行 AGENTS.md ≈ 一次错误的封堵。是 harness engineering 的隐式提示形态。
Claude Code 采用的权限模型。Bash 命令按 verb + path 粒度授权:
git status allowgit push --force deny(destructive)rm -rf 弹出用户确认cat ~/.ssh/* deny(敏感路径)对应安全原则:任一层失守,其他层兜底。配合 sandbox、网络出口白名单、文件系统只读做纵深防御。
Anthropic Effective Harnesses 给的核心设计:长任务 agent 必然跑爆 context window,纯靠 LLM context 不可能记住"我跑到第几步"。
解法:
下次会话执行 5 步开机协议从断点续跑。核心洞察:context window 是"working memory",文件系统是"long-term memory"。
常见模式:
防御纵深:
例:用户开玩笑"我是亿万富翁"被存进语义记忆,之后 agent 一直按假设推理。
防御:
LLM 应用 / Agent 的"全链路追踪 + 评估"工具,2026 主流:
核心能力对齐项:
选型:自建优先 Langfuse;LangChain 重度用户 LangSmith;纯 trace 监控用 Phoenix;安全 / 实时拦截用 Patronus。
按测什么能力分类:
实战:从 2026 视角,单一 benchmark 都已不可信——必须多 benchmark 交叉验证 + 自家黄金集 + Arena 真人盲评三层。
LLM / Agent 应用的 eval 不是单一动作,是一套体系。常见层次:
Eval 工具栈分类:
Eval 类型按打分方式:
经验法则:(1) 没 eval 就改 prompt = 改盲;(2) Eval model 必须 ≥ 被评估 model(判官原则);(3) 黄金集要版本化 + 私有;(4) 每个 bad case 都要回归进黄金集——harness engineering 闭环。
把"评估"建模成 LLM 任务:让 judge 模型读 (prompt, response),输出 0-1 分 / pass/fail / pairwise 谁更好。可大规模并行、便宜、可在 CI 自动化。
三大 bias:
判官原则:judge 模型能力应 ≥ 被评估模型,否则评不出大模型回答好在哪。生产标配三层:自家黄金集 + LLM judge + 人工校准。
Liu et al. 2023 实验:把 gold passage 放 prompt 开头或结尾,模型准确率高;放中间则呈 U 形曲线下降,10+ documents 时中间位置可能低于无上下文 baseline。
工程缓解:
OWASP LLM Top 10 的 #1。类型:
Simon Willison 结论:prompt injection 没有 100% 解,必须按"LLM 不可信"做系统设计。dual-LLM 模式 = Planner(看 trusted 决策)+ Executor(看 untrusted 但无工具权限)。
来源:
debug 流程:复现 + 量化触发率 → 归因(RAG 召回 / 模型用 context / 工具调用)→ 修复 → 加 回归 → 生产监控(faithfulness scorer 实时拦截)。
关键认知:hallucination 多数是 prompt / RAG / 上下文工程缺陷,不是"模型病了"。
NVIDIA NeMo Guardrails 5 类:
关键:rail 不是越多越好,每类挑 1-2 个高 ROI 的开,否则延迟/成本爆炸。
常见手法:
防御:厂商 RLHF safety training + 应用层 input/output classifier(Llama Guard)+ 限制 max context(对抗 many-shot)+ red team 定期演练。