Building Effective Agents · 中文翻译
原文发布:2024-12-19 · 中文译稿:2026-05-14
本文为社区学习用途的非官方中文翻译。技术名词以括注英文原文为准;最终解释以英文原文为准。
过去一年里,我们与数十支跨行业的团队合作构建大型语言模型(LLM)Agent。我们持续观察到一个现象:最成功的实现并没有依赖复杂的框架或专用的库,而是用简单、可组合的模式搭建出来的。
本文分享我们与客户合作以及自己构建 Agent 过程中沉淀的经验,为开发者提供构建高效 Agent 的实践建议。
"Agent" 一词可以有多种定义。一些客户把 Agent 视为完全自主的系统:长时间独立运行、调用各种工具完成复杂任务。另一些人则用这个词指那些按预定义工作流执行的、更"规定动作"式的实现。在 Anthropic,我们把这些变体统称为 Agentic 系统(agentic systems),但在架构上明确区分 工作流(workflows) 与 Agent:
下文会详细探讨这两类 agentic 系统。在附录一("Agent 实战")中,我们会介绍两个客户特别看重 Agent 价值的领域。
构建基于 LLM 的应用时,我们建议先找最简单的方案,仅在必要时才提升复杂度——很多时候根本不需要 agentic 系统。Agentic 系统通常用更高的延迟和成本换取更好的任务表现,你需要判断这种权衡是否值得。
当复杂度确有必要时:工作流适合任务定义清晰、要求可预测性与一致性的场景;Agent 适合需要大规模灵活性和模型驱动决策的场景。但对许多应用而言,结合检索(retrieval)与上下文示例(in-context examples)优化单次 LLM 调用就已经足够。
有不少框架可以让 agentic 系统的实现更轻松,包括:
这些框架封装了调用 LLM、定义和解析工具、串联调用等底层细节,便于上手。但它们往往引入额外的抽象层,让底层 prompt 和响应变得不透明、更难调试,也容易诱使你在简单方案就够用的场景里盲目加复杂度。
我们建议开发者先直接使用 LLM API:很多模式只需几行代码就能实现。如果确实要用框架,请确保你理解底层代码——对"引擎盖下到底发生了什么"的错误假设是客户出错的常见来源。
可以参考我们的 cookbook 里的示例实现。
本节梳理我们在生产环境中观察到的 agentic 系统常见模式。我们从最基础的构建块——增强型 LLM(augmented LLM)——开始,逐步提升复杂度:从简单的组合式工作流,一直到自主 Agent。
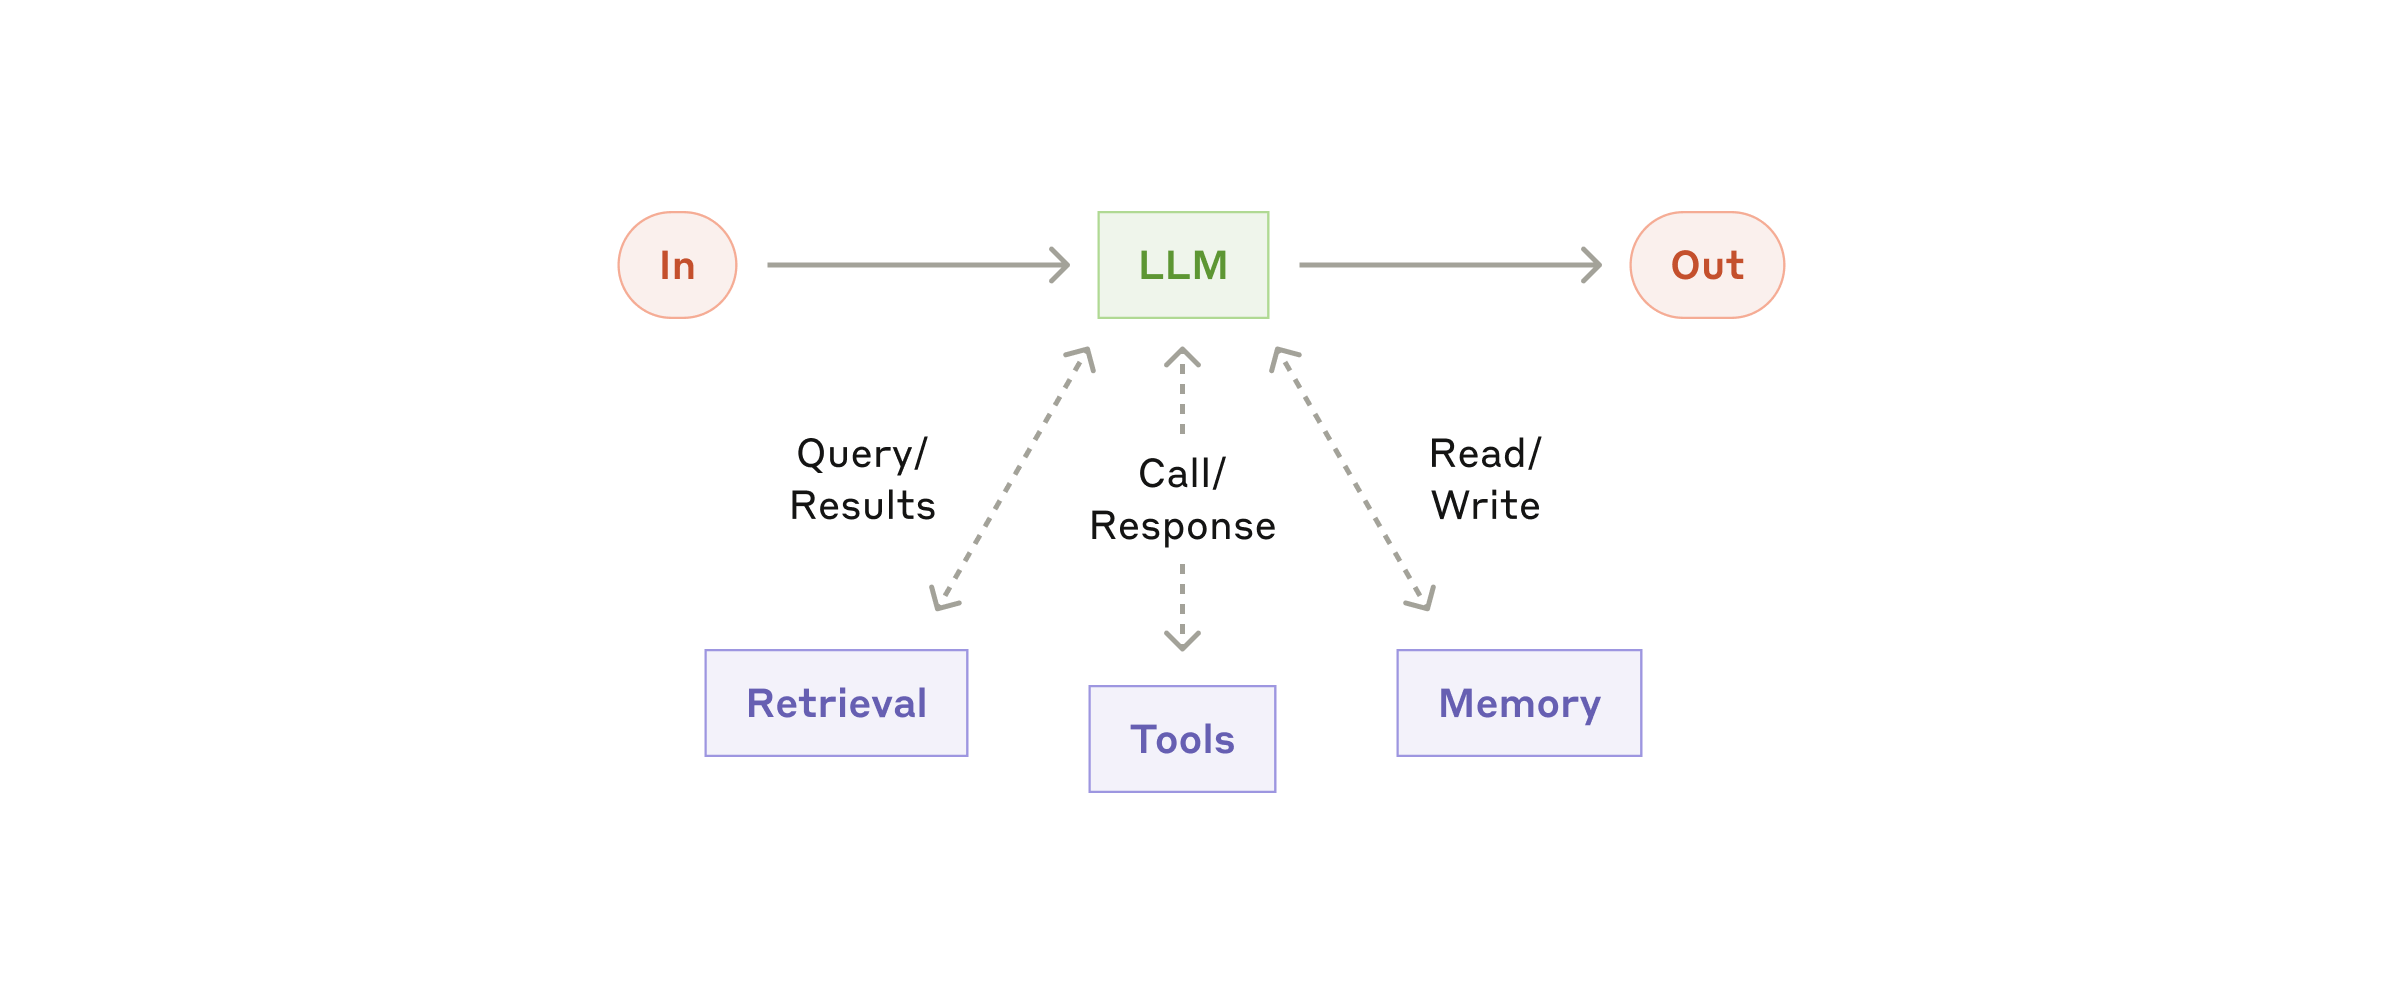
agentic 系统的基础构建块是一个被增强过的 LLM,常见增强能力包括检索、工具、记忆。我们当前的模型可以主动使用这些能力——自己生成搜索 query、挑选合适的工具、决定要保留哪些信息。
我们建议聚焦实现层的两件事:把这些能力针对你的具体场景做定制,并为 LLM 提供简洁、文档清晰的接口。实现方式很多,其中一条路径是借助我们最近发布的 Model Context Protocol:开发者只需写一个简单的 client,就能接入快速扩张的第三方工具生态。
本文剩余部分默认每次 LLM 调用都已经具备这些增强能力。
提示链把一个任务拆解为一连串步骤,每次 LLM 调用都处理上一次调用的输出。你可以在任意中间步骤插入程序化检查(即下图中的 "gate"),确保流程仍在轨道上。
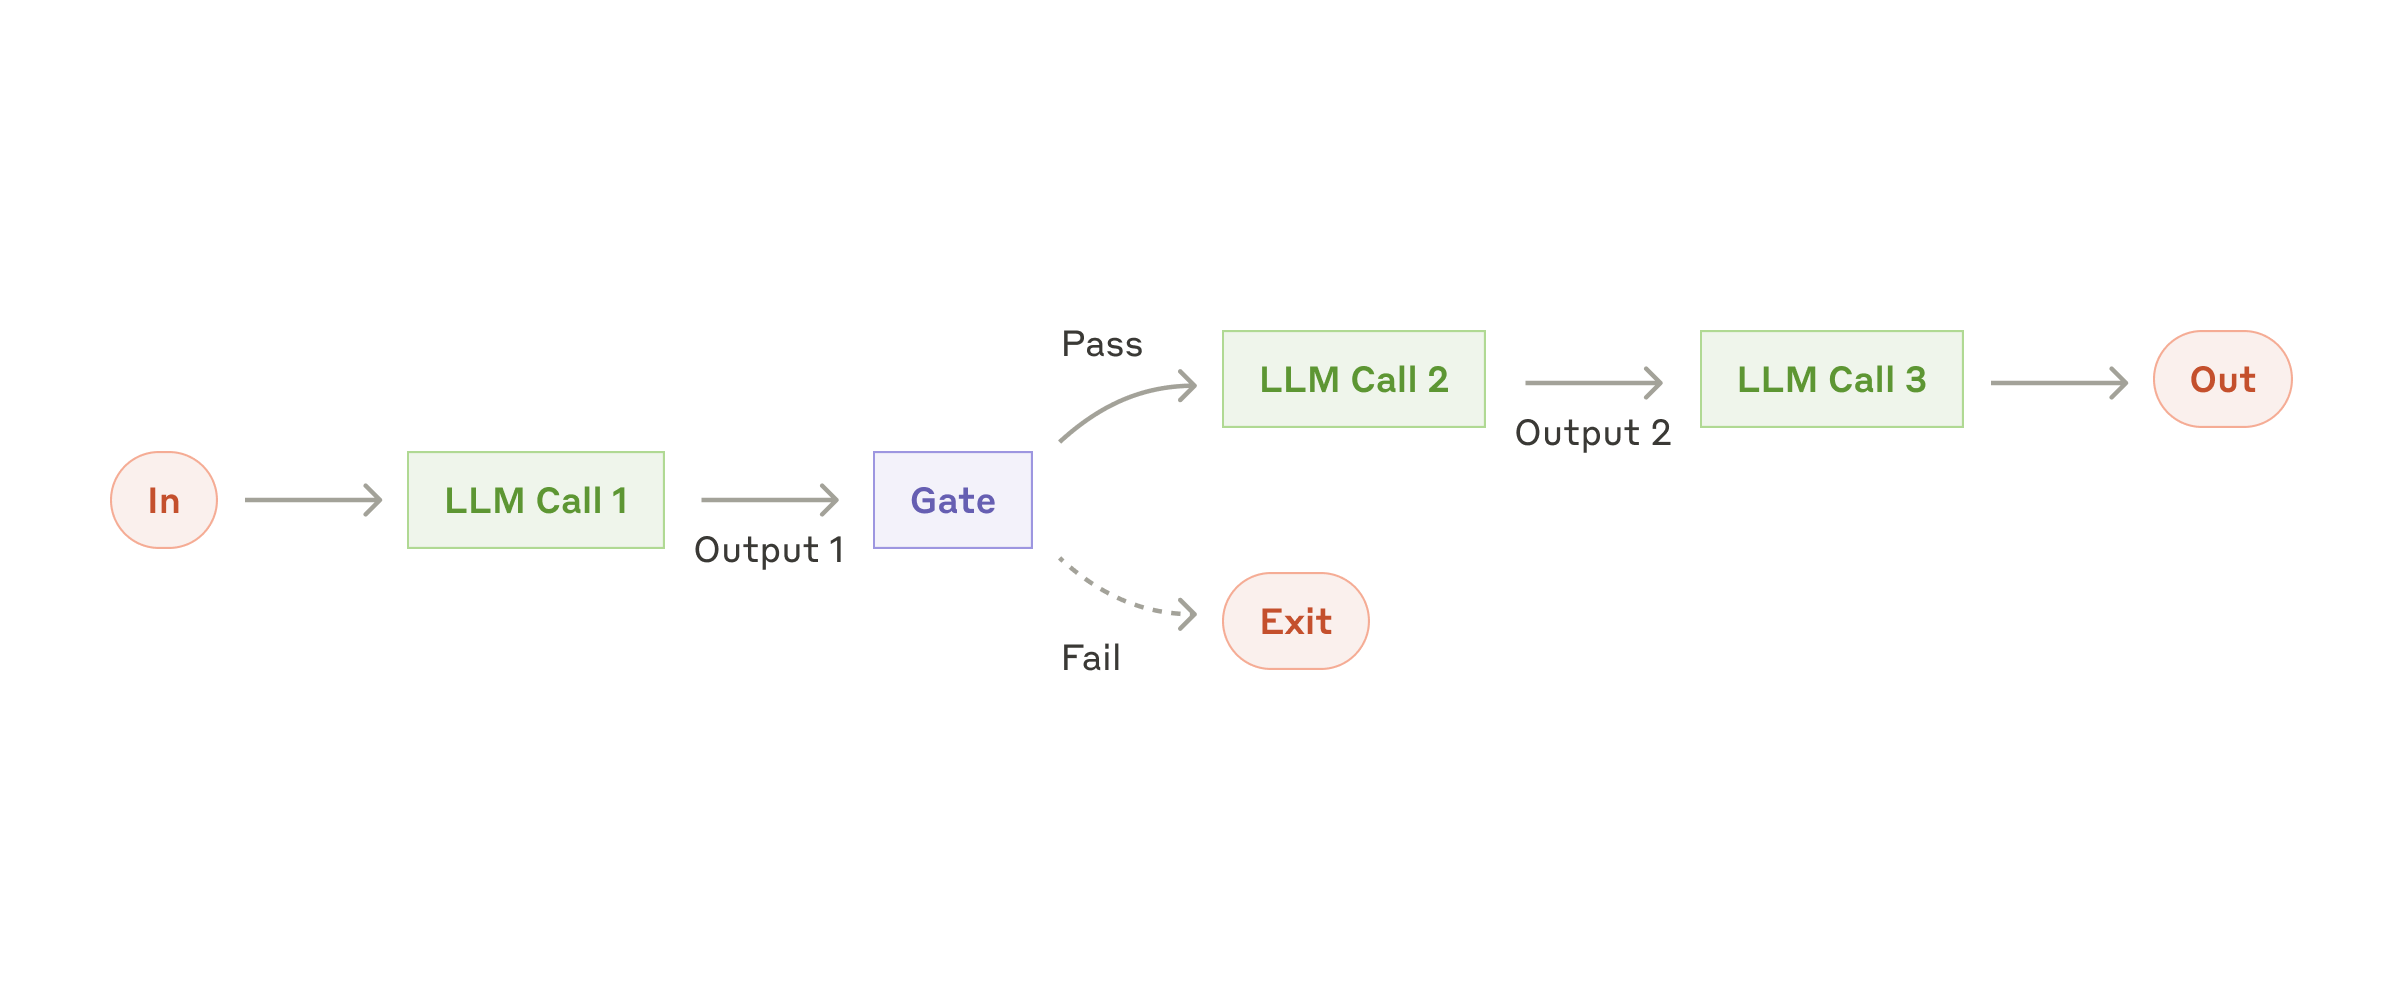
何时使用: 当任务可以干净利落地拆成固定子任务时。主要目的是用更高的延迟换更高的准确率——每一次 LLM 调用都变成更简单的子任务。
适用示例:
路由对输入做分类,再把它导向某个专门的后续任务。这种工作流可以做到关注点分离、为每类输入构造更专门的 prompt——否则针对一类输入的优化往往会拖累其他输入的表现。
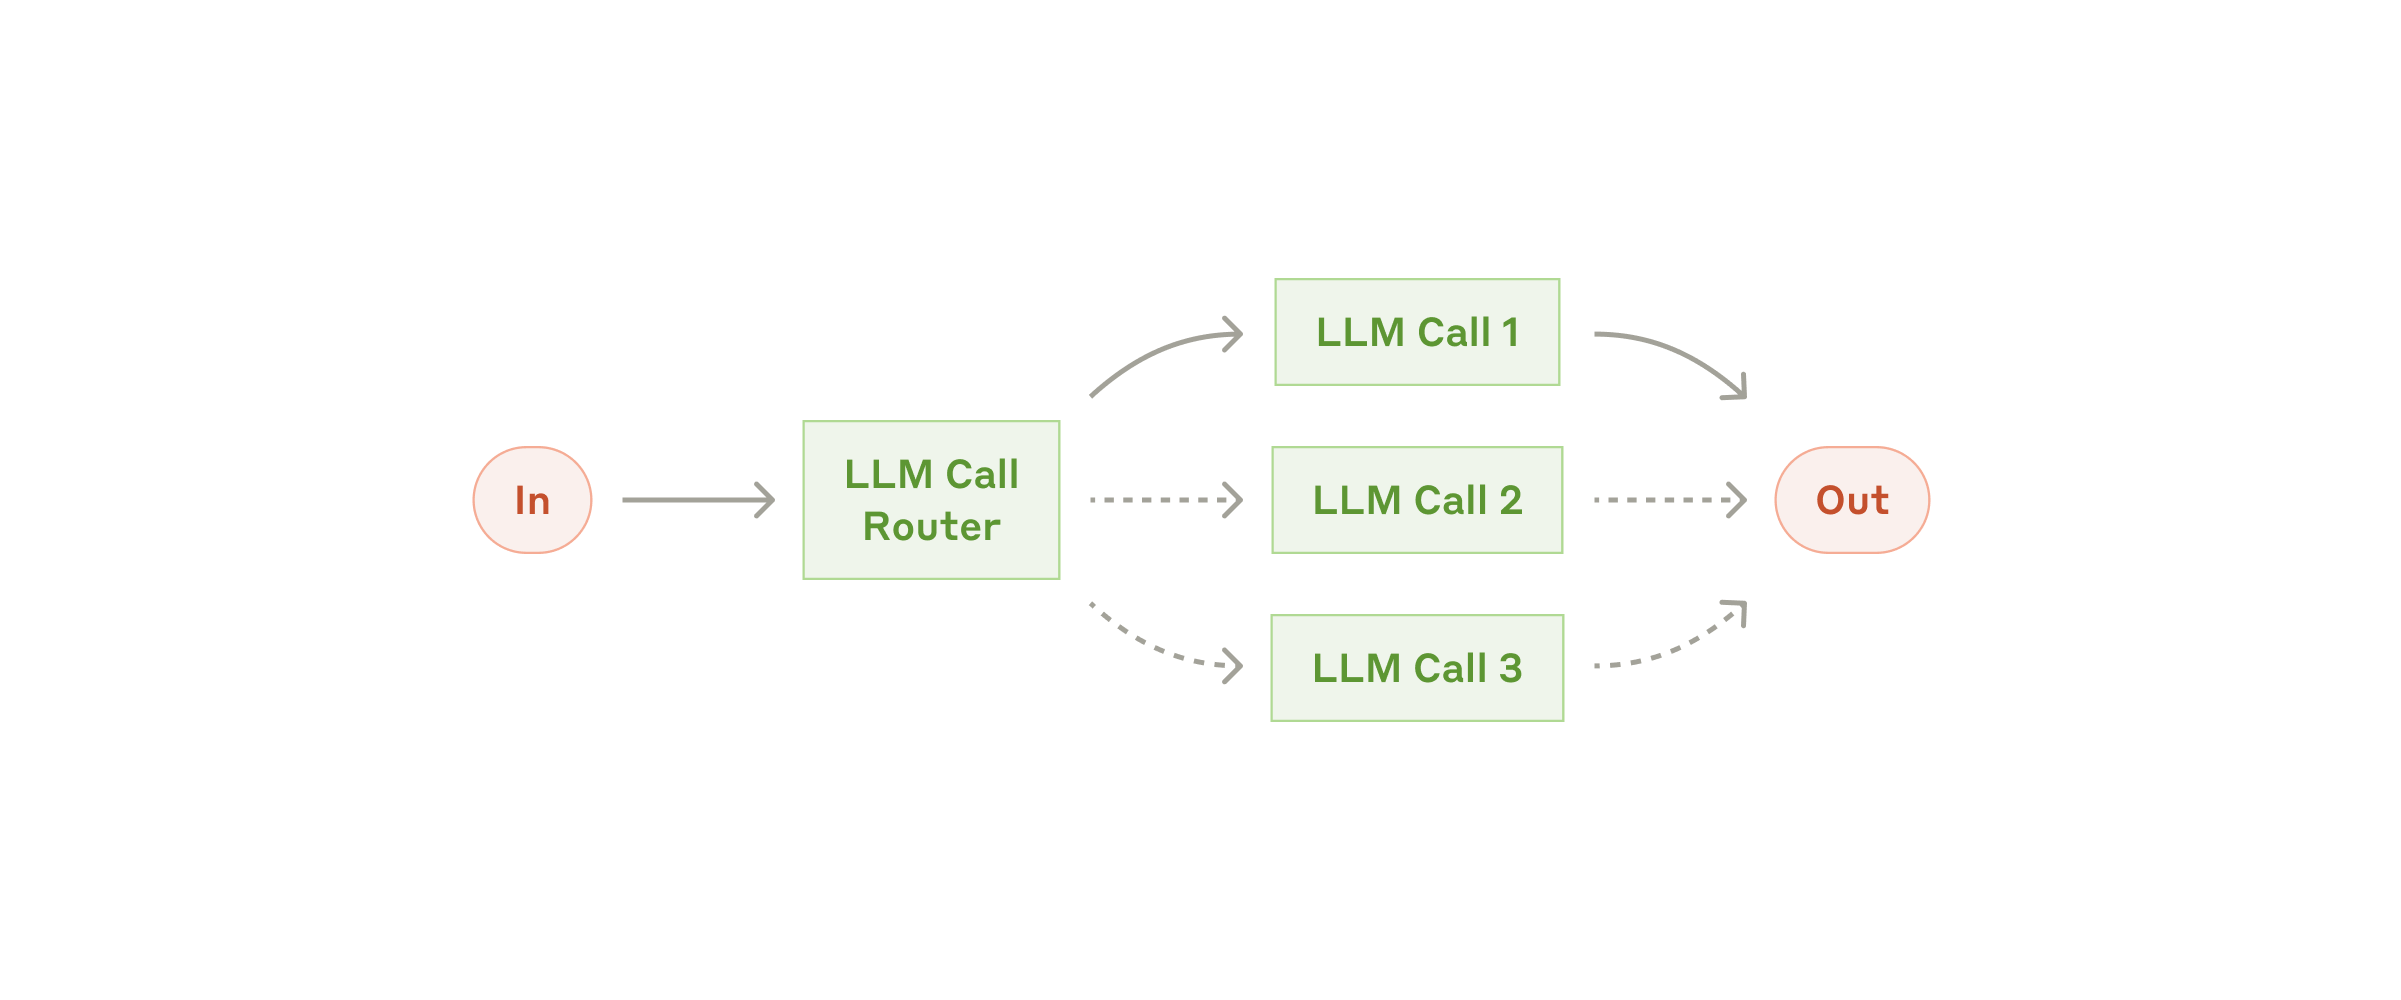
何时使用: 当任务有可清晰区分的类别、且这些类别更适合分别处理,并且能用 LLM 或传统分类模型/算法准确分类时。
适用示例:
LLM 有时可以并行处理任务,最终再把各路输出程序化地合并起来。这种"并行化"工作流有两种主要变体:
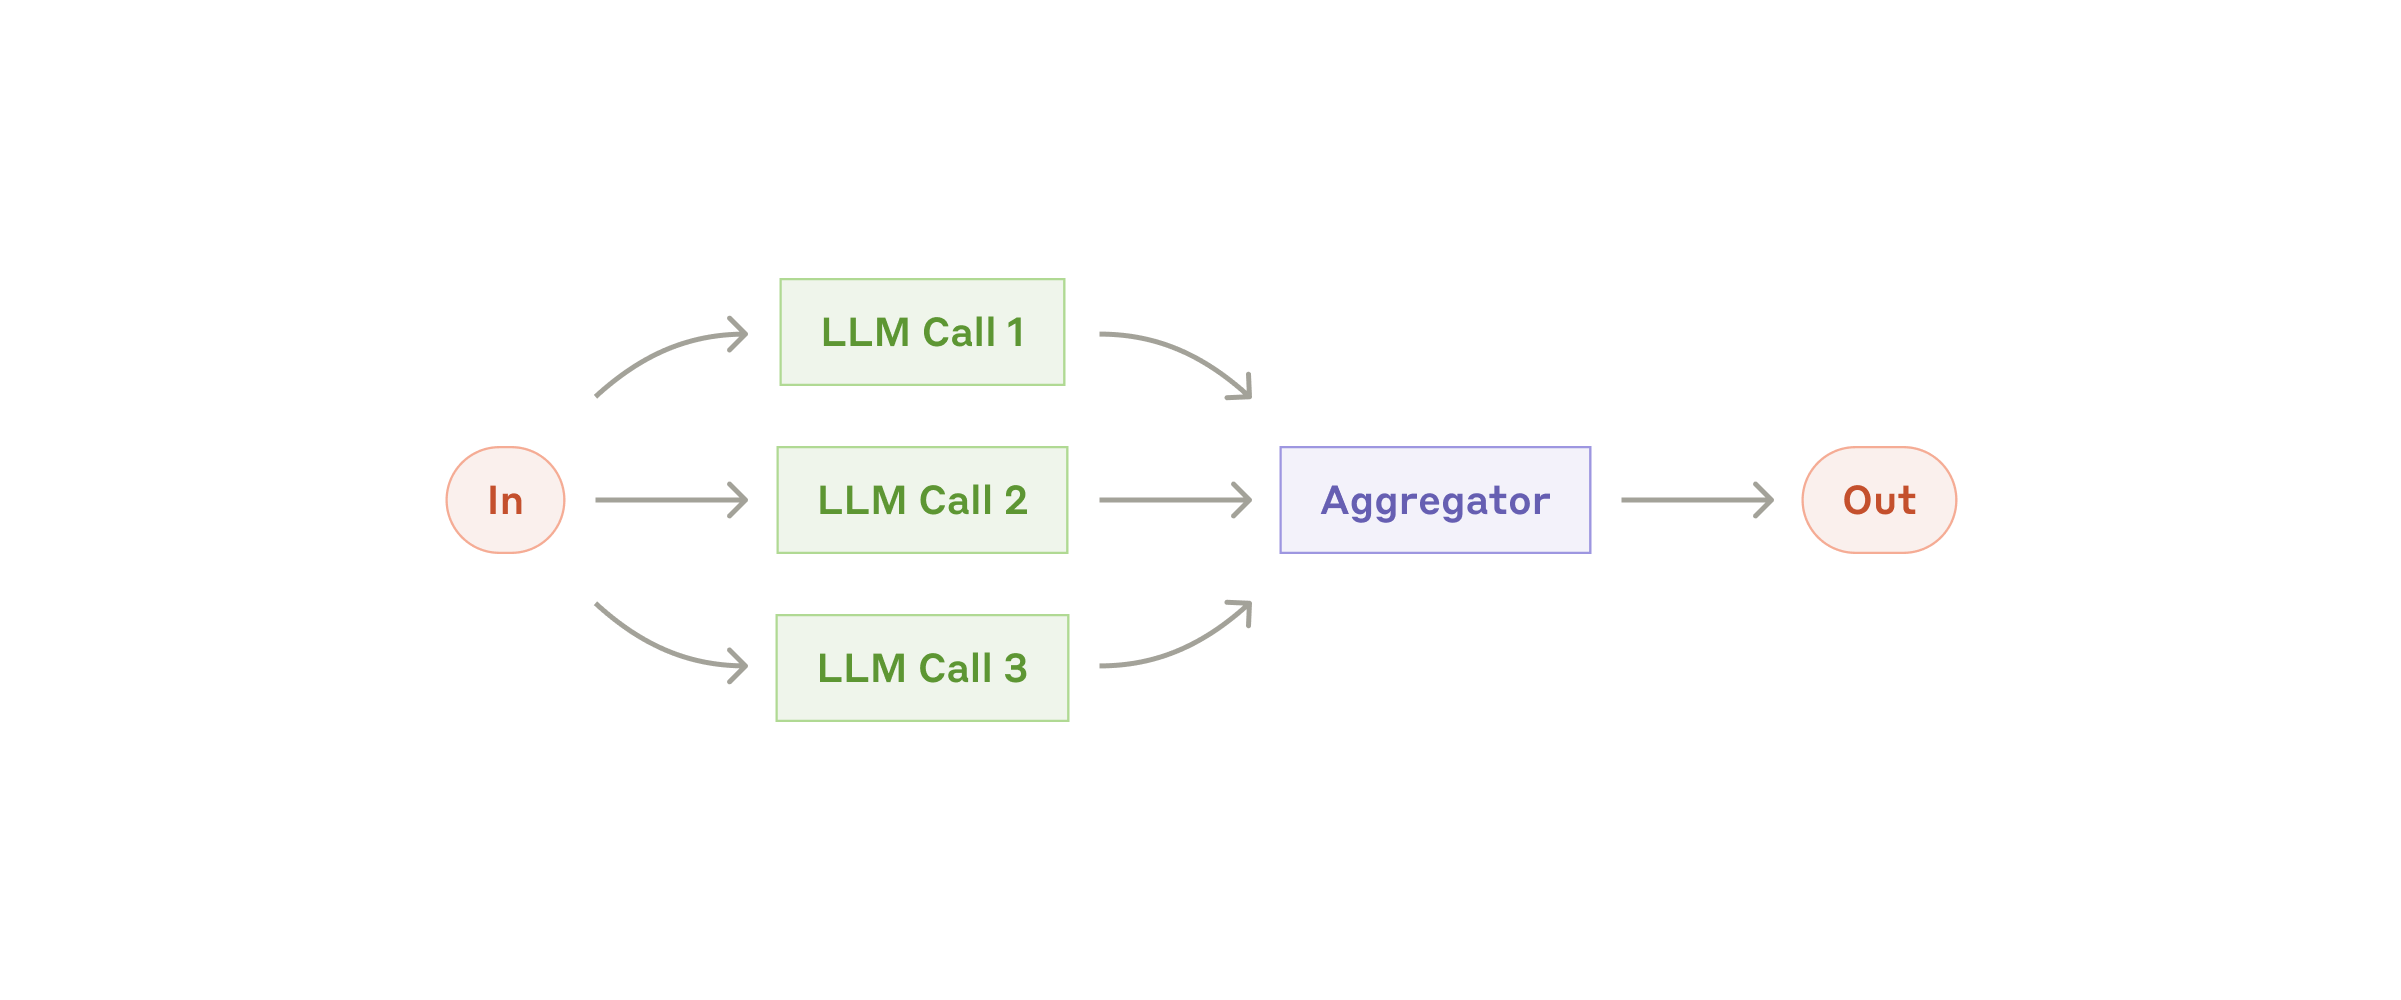
何时使用: 当拆分出的子任务可以并行以加速、或需要多个视角/多次尝试来提升结果置信度时。对于多维度的复杂任务,每个维度让独立的 LLM 调用专注处理往往效果更好。
适用示例:
在编排者-工作者工作流中,一个中心 LLM(orchestrator)动态拆分任务、把子任务派发给若干 worker LLM、然后汇总它们的结果。
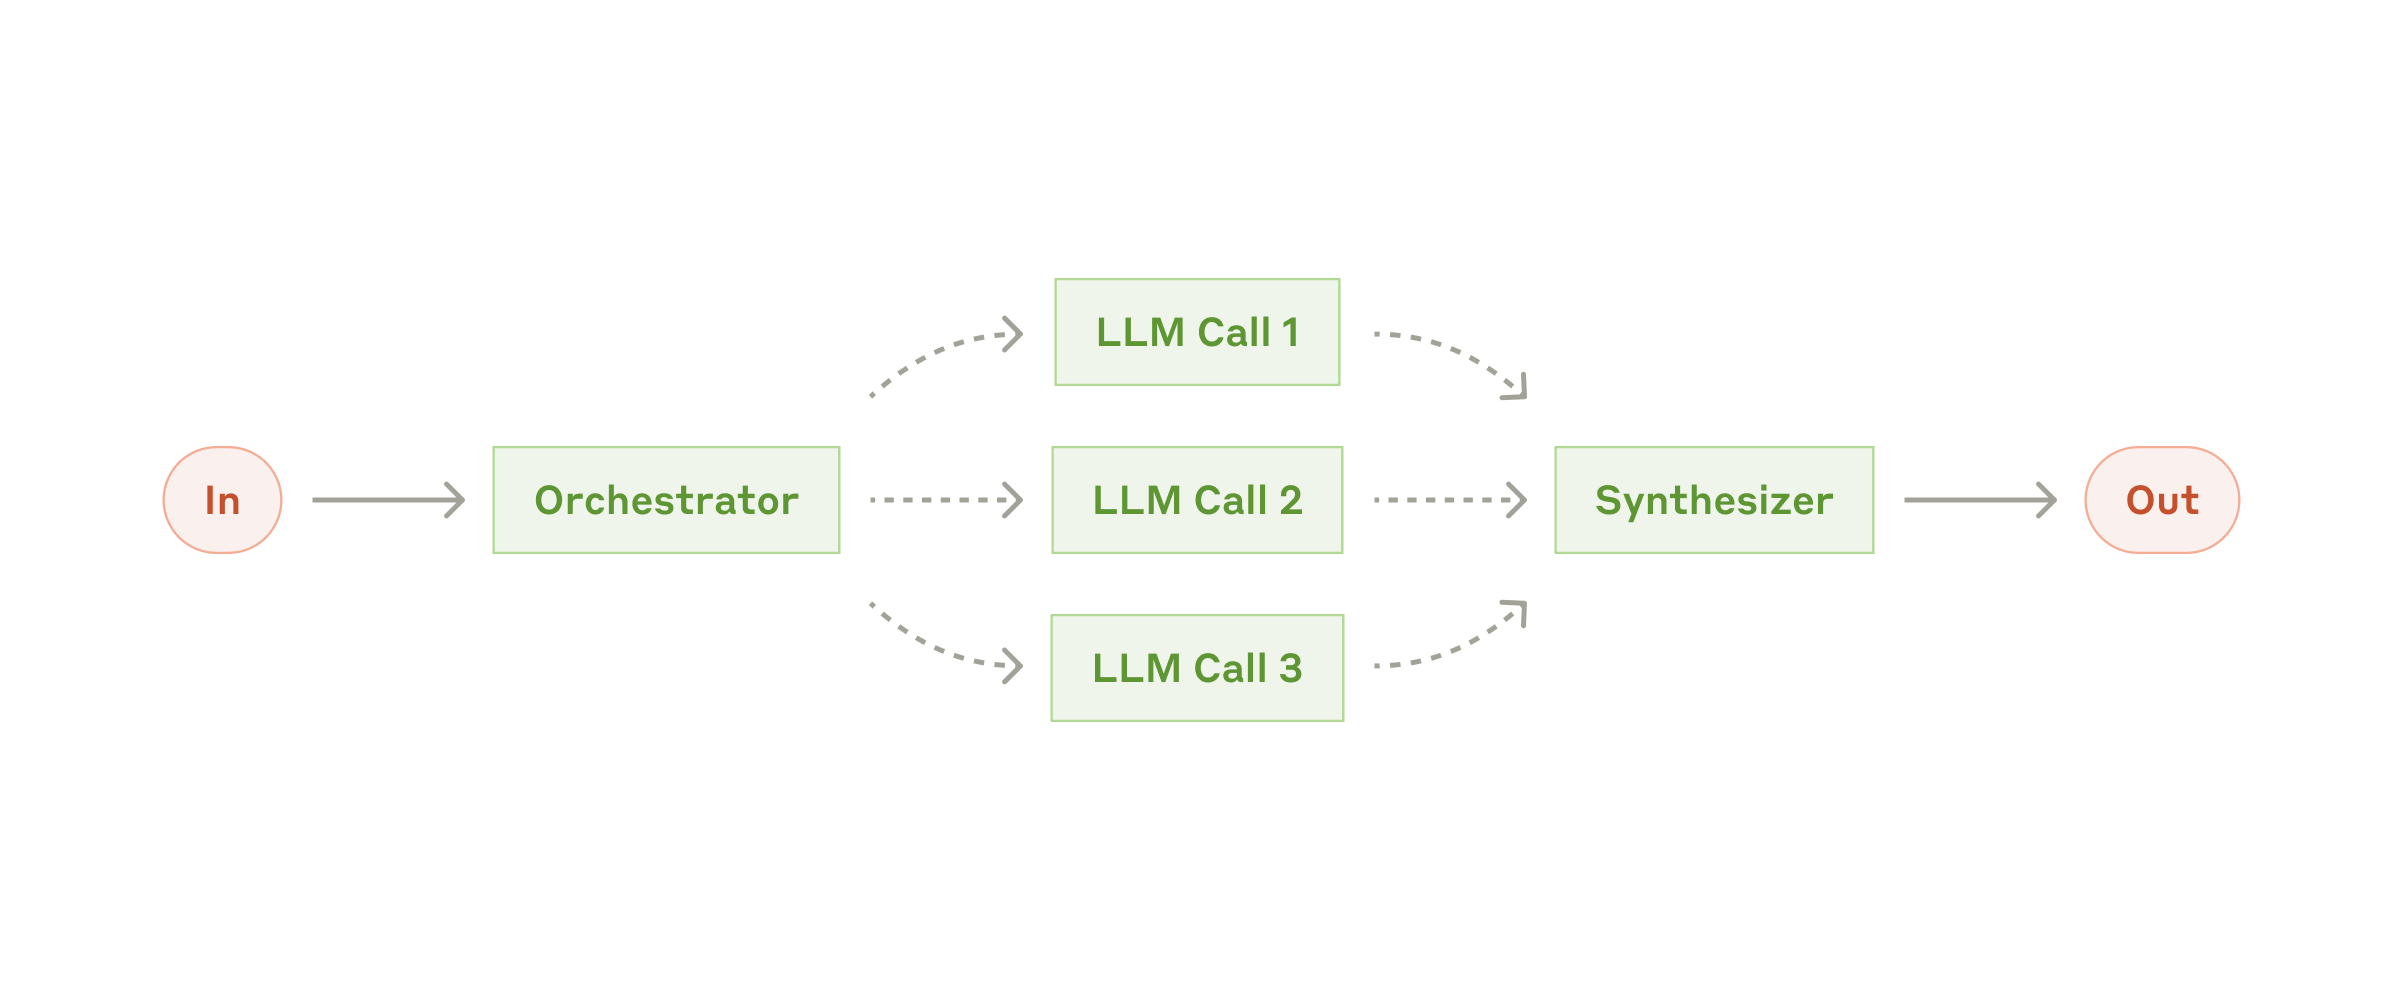
何时使用: 适合那些子任务无法事先预知的复杂任务(例如编程:要改几个文件、每个文件要怎么改,都取决于具体任务)。它在拓扑上看起来和并行化相似,但关键区别在于灵活性——子任务不是预先定义的,而是由编排者根据具体输入临时决定。
适用示例:
在评估者-优化者工作流中,一个 LLM 调用负责生成回复,另一个 LLM 调用在循环中提供评估和反馈。
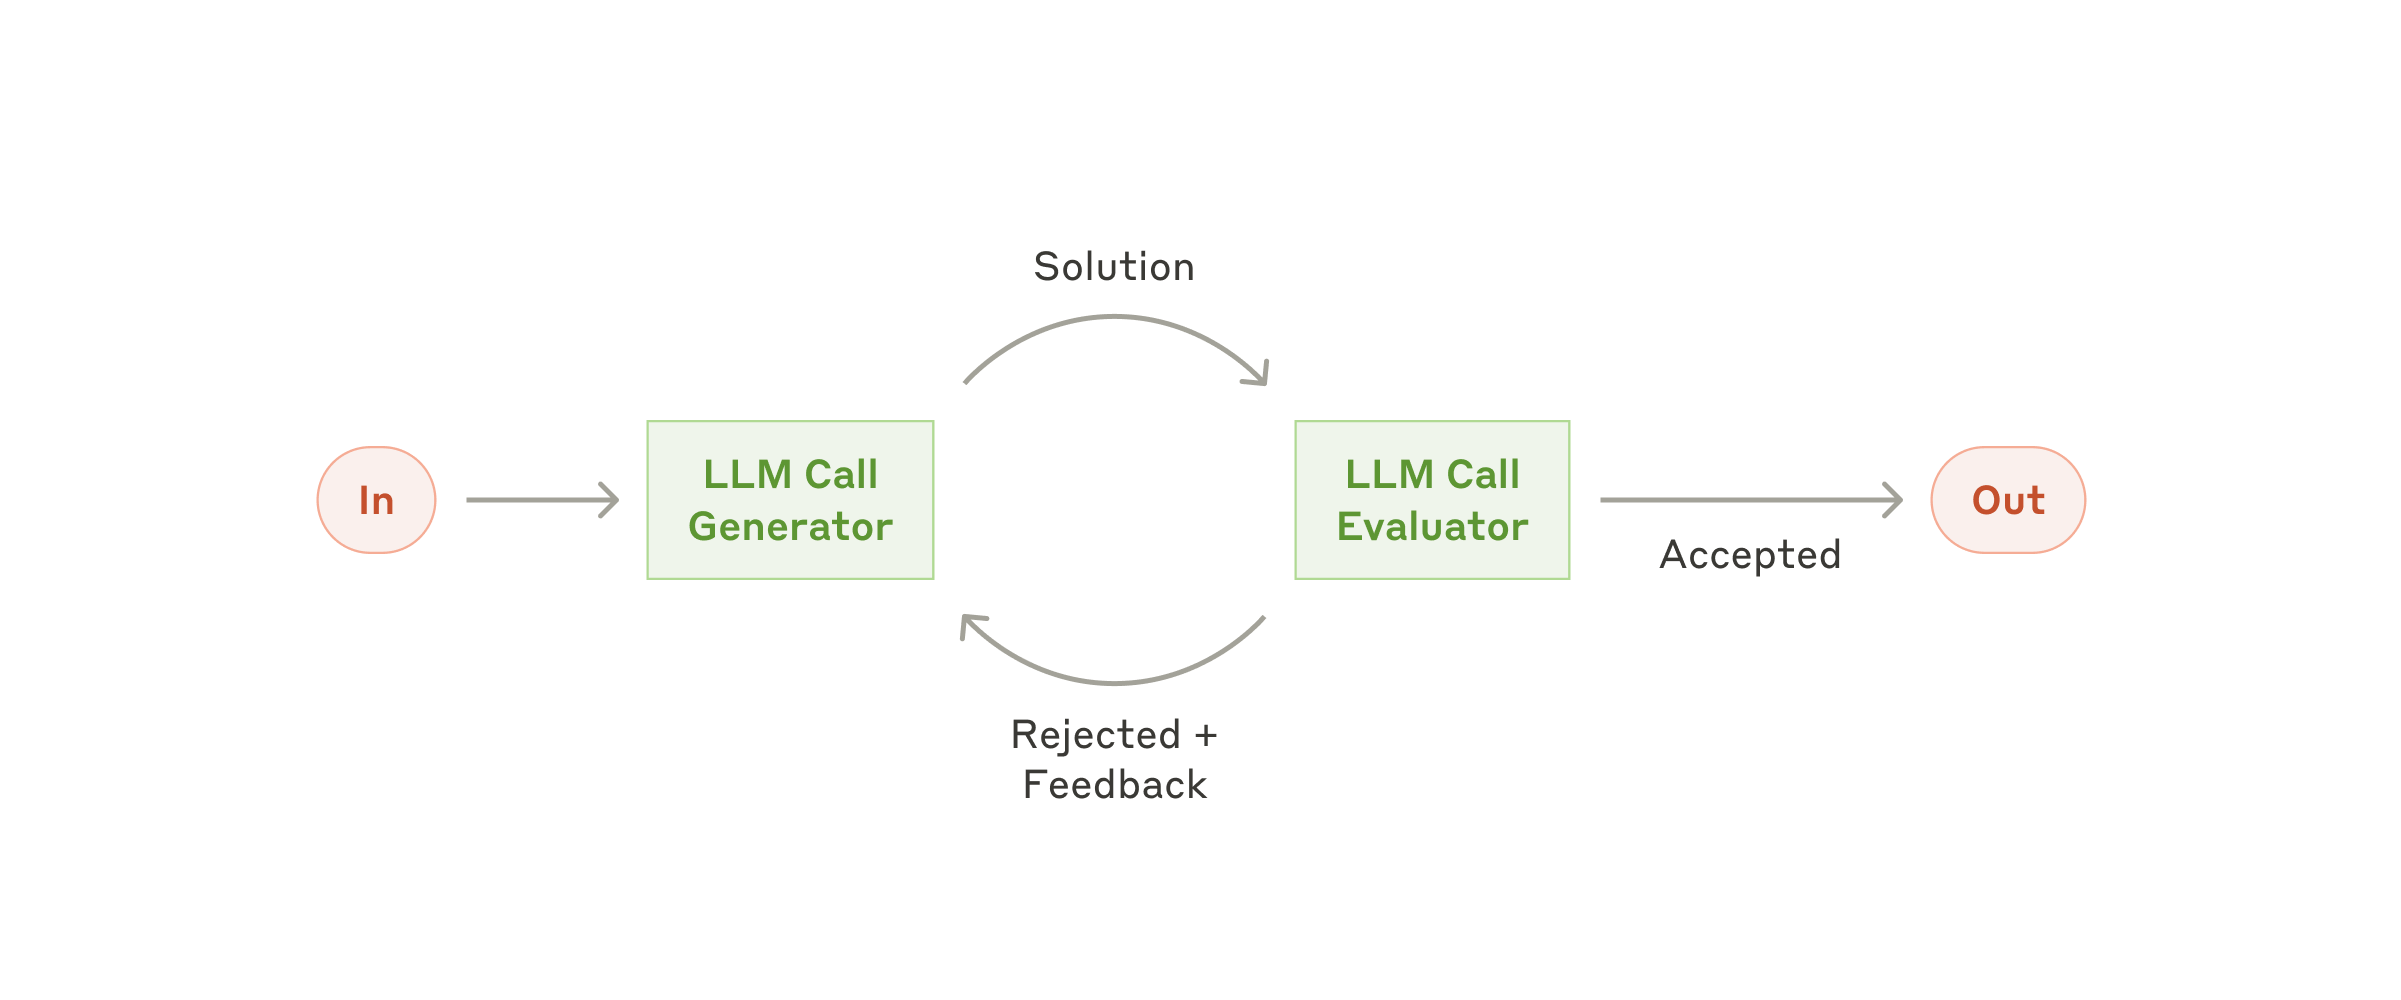
何时使用: 当我们有清晰的评估标准、且迭代式打磨能带来可衡量的提升时。两个判别信号:第一,当人提出反馈时 LLM 的回复明显能变好;第二,LLM 自己也能产出这样的反馈。这类似于人类作者打磨一份成熟文档时的迭代写作过程。
适用示例:
随着 LLM 在关键能力上的成熟——理解复杂输入、推理和规划、可靠地使用工具、从错误中恢复——Agent 正在生产环境中崭露头角。Agent 的工作起点通常是用户的一条命令或一次交互式讨论。任务清晰后,Agent 独立规划和执行,必要时回到人类身边获取更多信息或判断。执行过程中,让 Agent 在每一步都从环境中获得 "ground truth"(工具调用结果、代码执行结果等)来评估自己的进度至关重要。Agent 可以在检查点处或遇到阻塞时暂停等待人类反馈。任务完成时通常自然终止,但通常也会加上停止条件(比如最大迭代次数)以保持控制。
Agent 能处理复杂任务,但实现往往很直白——本质上就是一个 LLM 在循环中根据环境反馈使用工具。因此,精心设计你的工具集和工具文档至关重要。我们在附录二("为工具做 Prompt Engineering")中展开介绍工具开发的最佳实践。
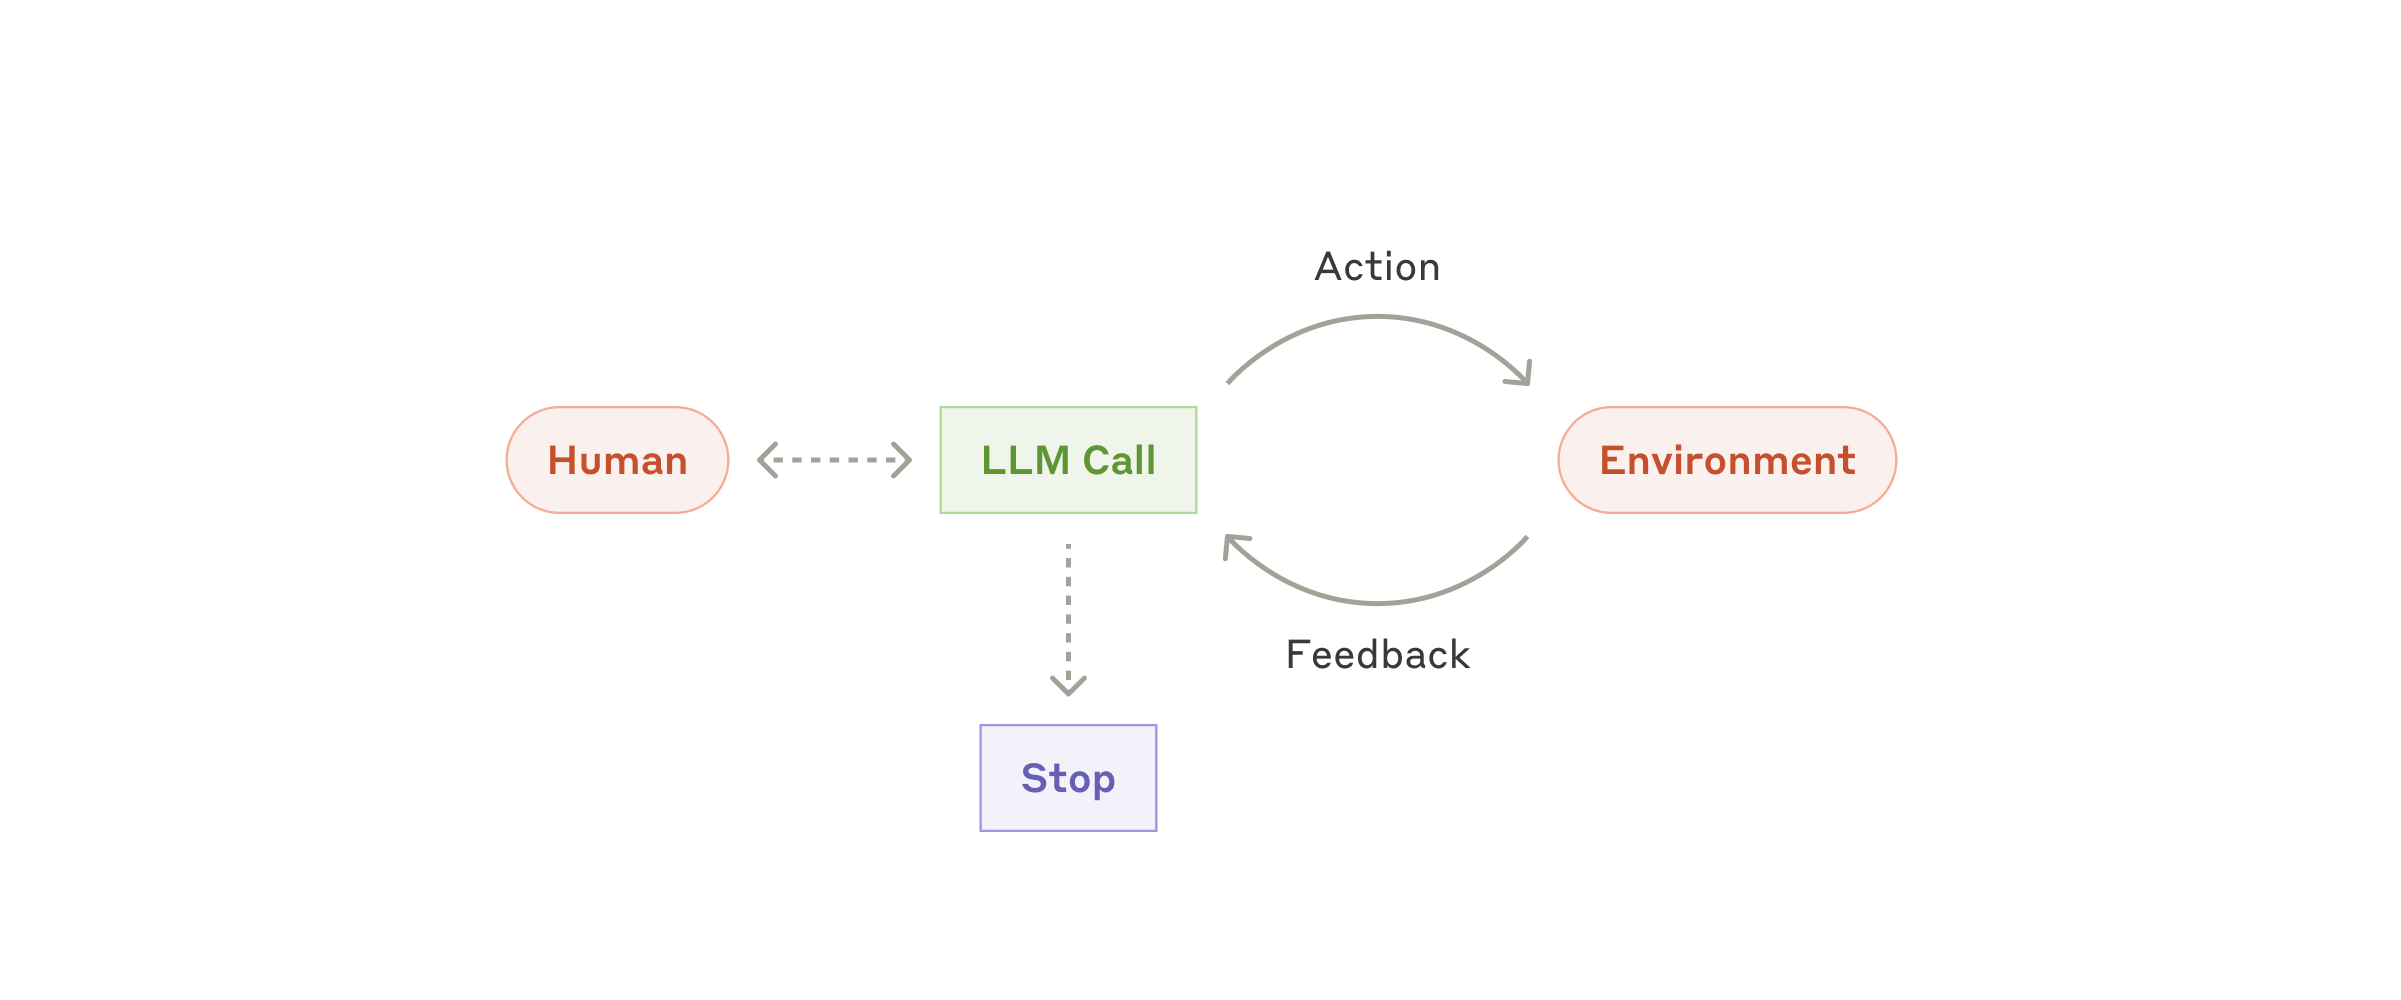
何时使用 Agent: 适合开放式问题——很难甚至无法预测需要多少步、也写不出一条固定的代码路径。LLM 可能会跑很多轮,你需要对它的决策具备一定信任度。Agent 的自主性让它特别适合在可信环境中扩展任务规模。
但自主性同时意味着更高的成本和错误累积的可能。我们建议在沙箱环境中做充分测试,并配上合适的护栏(guardrails)。
适用示例:
下列示例来自我们自己的实现:
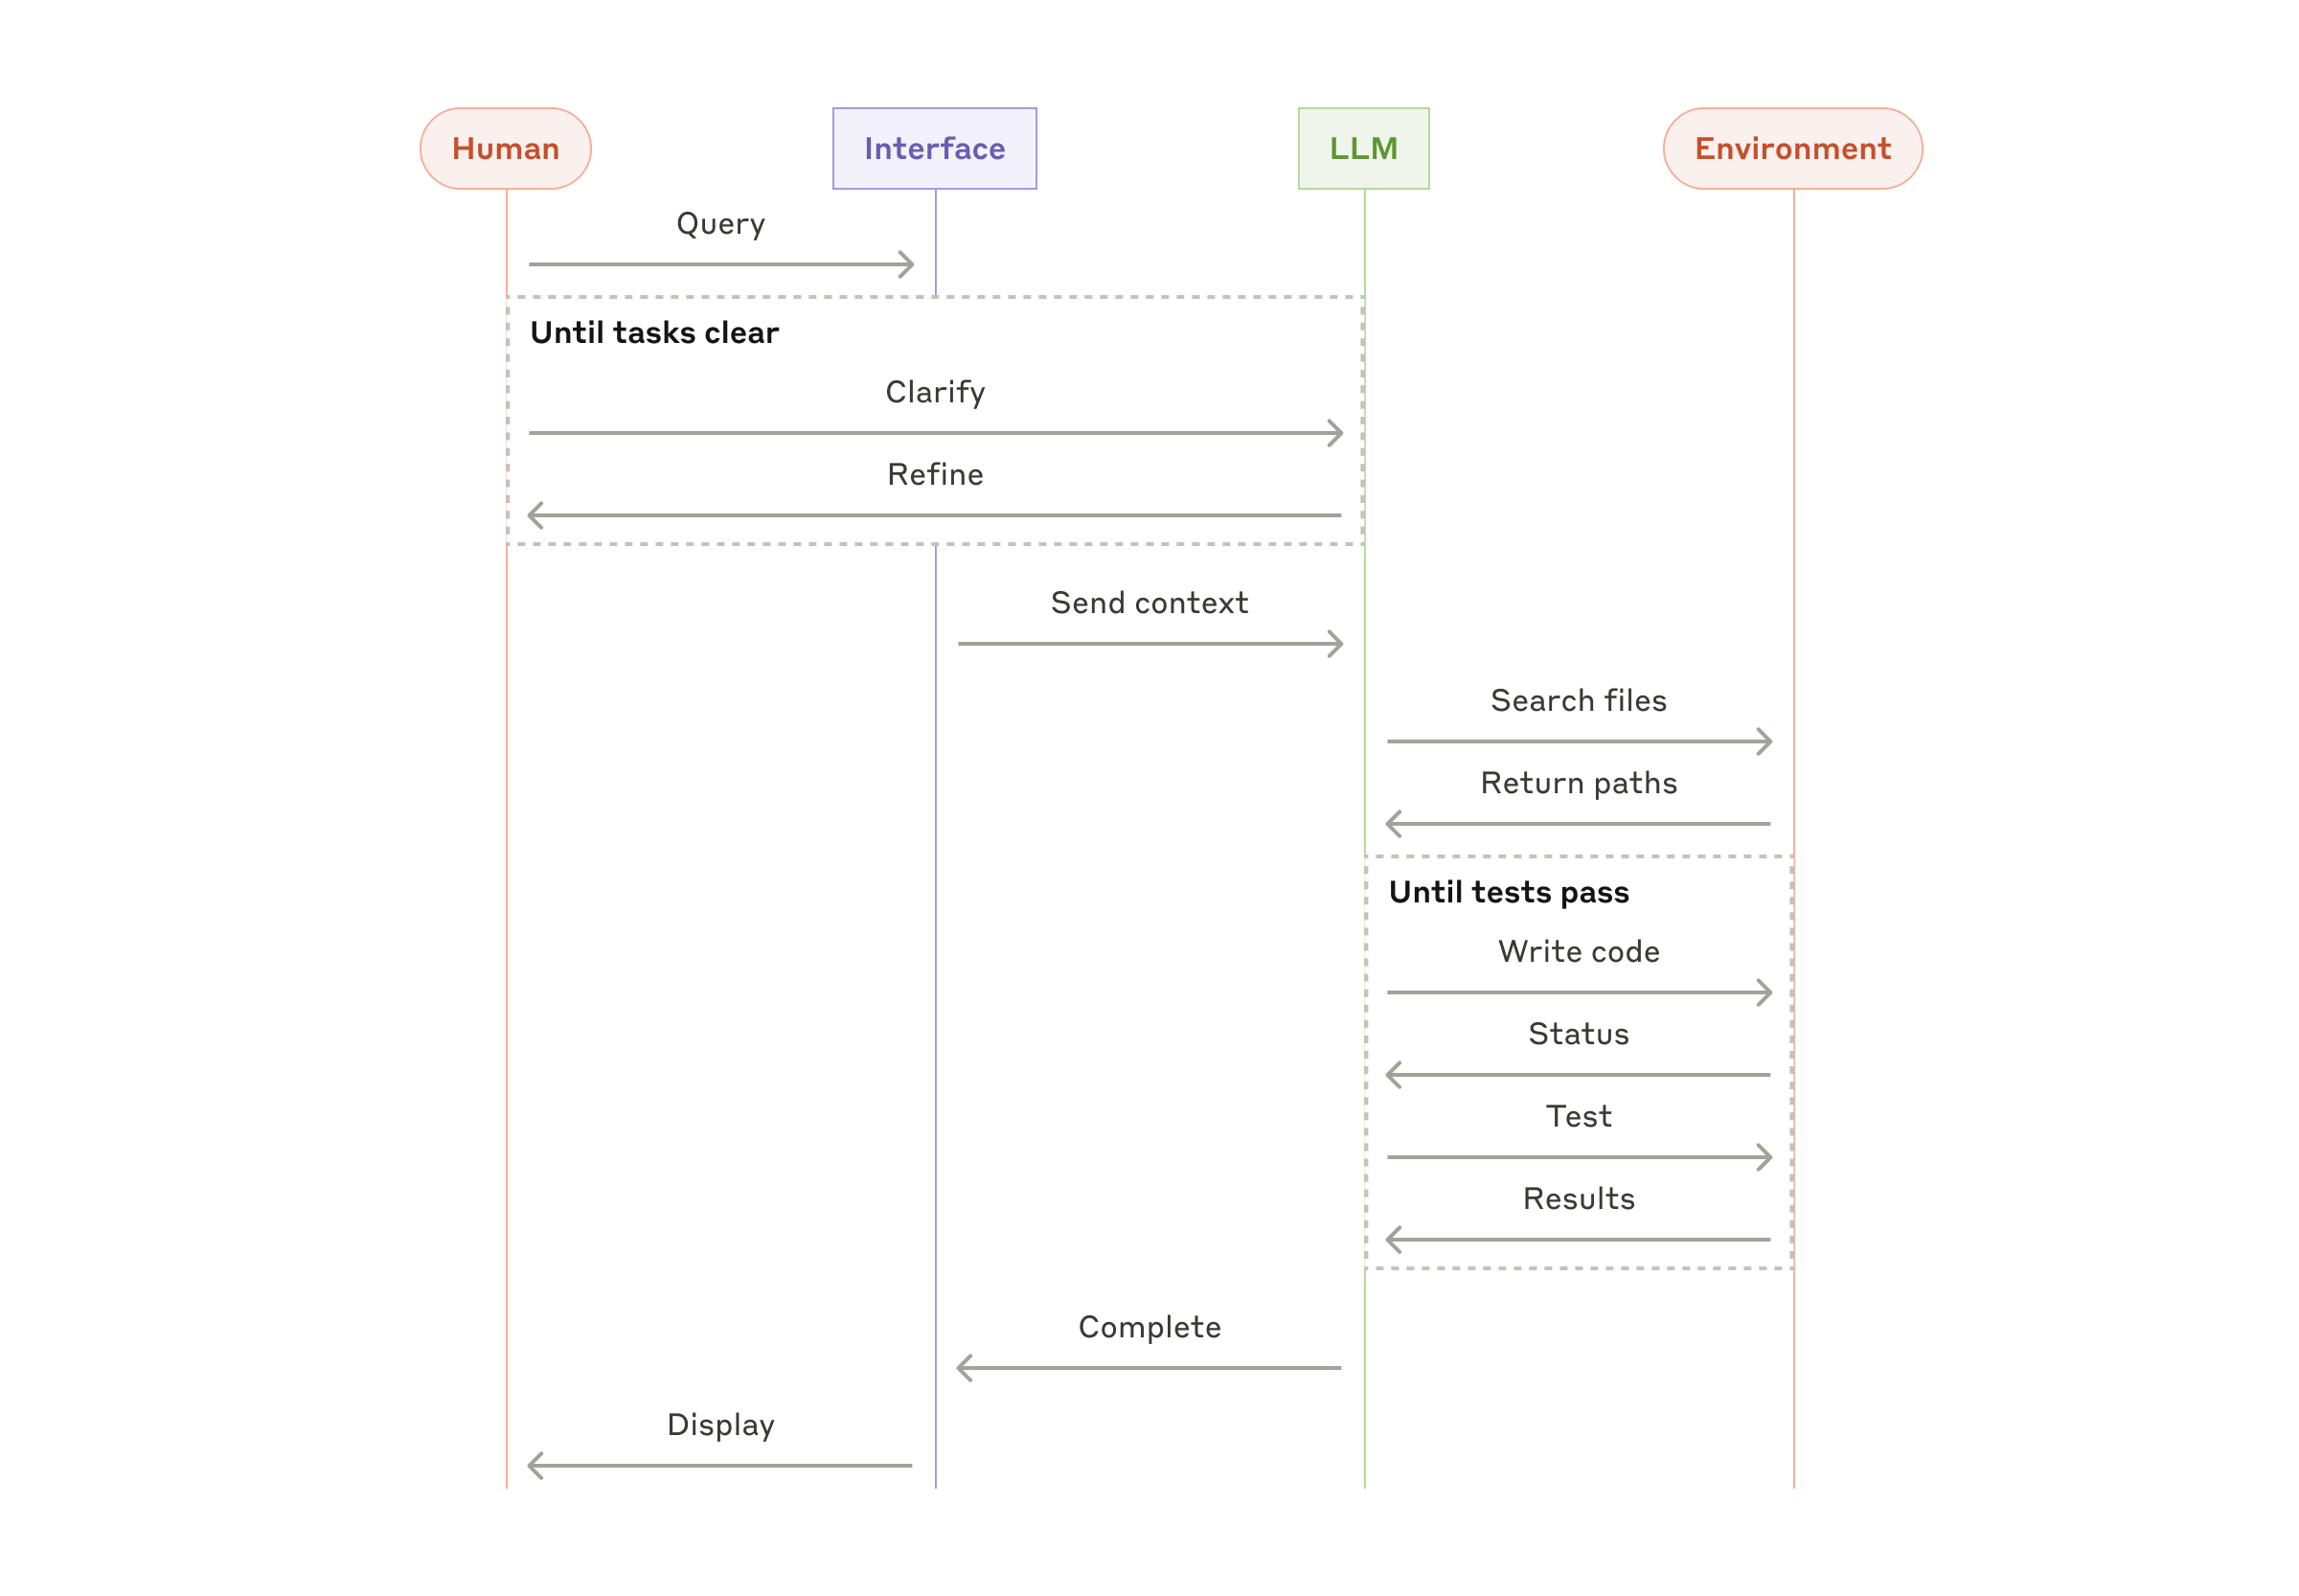
这些构建块不是教条。它们是常见模式,开发者可以根据使用场景重新塑形和组合。成功的关键——和任何 LLM 特性一样——是度量表现并迭代实现。再强调一次:只有当复杂度能明确改善结果时才去增加它。
LLM 领域的成功不是建出最复杂的系统,而是建出最适合你需求的系统。先从简单的 prompt 开始,用全面的评估来优化,只有在简单方案显著不足时才加多步的 agentic 系统。
实现 Agent 时,我们尽量遵循三条核心原则:
框架能帮你快速起步,但向生产环境推进时不要犹豫——拆掉抽象层,用基础组件搭建。遵循上述原则,你能造出不仅强大、同时可靠、可维护、被用户信任的 Agent。
由 Erik S. 与 Barry Zhang 撰写。本文凝结了我们在 Anthropic 构建 Agent 的经验,以及客户分享的宝贵洞见——在此深表谢意。
我们与客户合作的过程中,看到两类对 AI Agent 特别有前景的应用,能很好地展示前面所述模式的实际价值。两类应用都说明:Agent 在那些同时需要对话与行动、有明确成功标准、能形成反馈闭环、并且能融入有意义的人类监督的任务中提供的价值最大。
客户支持把熟悉的 chatbot 界面和工具集成带来的增强能力结合起来。它非常适合做更开放式的 Agent,因为:
已有多家公司用按结果计费的定价模型(只有成功解决才收费)证明了这条路径的可行性,也表明他们对自家 Agent 的效果有信心。
软件开发领域展现了 LLM 特性的巨大潜力,能力从代码补全演进到自主问题求解。Agent 在这里特别有效,因为:
在我们自己的实现里,仅凭一条 pull request 描述,Agent 现在就能解决 SWE-bench Verified 基准里的真实 GitHub issue。但需要注意:尽管自动化测试能验证功能正确性,人工评审仍然不可或缺——它确保方案符合更广义的系统需求。
无论你构建的是哪种 agentic 系统,工具很可能是 Agent 的关键组件。Tools 通过在我们 API 中指定明确的结构和定义,让 Claude 能与外部服务和 API 交互。当 Claude 决定调用工具时,会在 API 响应中包含一个 tool use block。工具的定义和规范应该和你的整体 prompt 一样得到同等的 prompt engineering 投入。本附录简要介绍如何为工具做 prompt engineering。
同一个动作往往可以有多种表达方式。例如要描述一次文件修改,你可以让模型写 diff,也可以让它重写整个文件;要返回结构化输出,可以用 markdown 也可以用 JSON。在软件工程里,这些差异看似只是"外观"、理论上可以无损相互转换——但对 LLM 来说,有些格式比另一些难写得多。写 diff 需要在写新代码之前先在 chunk header 里准确数清楚有多少行在变;写嵌在 JSON 里的代码(相比 markdown)需要额外转义换行符和引号。
我们关于工具格式选择的建议:
一条经验法则:想想人们在打磨人机界面(HCI)上投入了多少精力,就应该在打磨 Agent-计算机接口(ACI) 上投入同样多的精力。一些做法建议:
我们为 SWE-bench 构建 Agent 时,优化工具花的时间比优化整体 prompt 还多。比如我们发现:Agent 走出根目录后,使用相对路径的工具就容易出错。修复方案是把工具改成始终要求绝对路径——之后模型用这个工具表现得近乎完美。
答案中以
[术语]标记的概念都可点击跳到本表对应条目并自动展开。本表按 10 个主题分组收录 60+ 高频术语,默认全部收起——遇到不熟的术语再展开看精要解释,避免被信息淹没。
不实际运行代码的情况下分析源码,识别潜在 bug、未使用变量、风格违规、可疑用法。常见工具:
在 Agent 工程中,lint 经常被用作 harness 的硬约束——把 lint 错误反馈给模型重写代码,比单纯在 prompt 里说"请遵守编码规范"可靠得多(Augment Code 把这叫做 Constraint Harness)。
确保代码中变量赋值、函数调用的类型一致:
对 Agent:让 agent 写完代码后强制跑 tsc --noEmit / mypy . / cargo check,类型错误作为反馈喂回模型继续修。比让 agent 自己"声明检查过类型"可靠得多——这是 harness 工程的典型做法。
CI(Continuous Integration):每次代码提交自动跑测试、构建、lint、type check 等校验。
CD(Continuous Deployment):通过校验后自动部署到测试 / 预发 / 生产环境。
常见工具:GitHub Actions、GitLab CI、Jenkins、CircleCI、Buildkite。
在 Agent 工程里,CI 是最重要的 deterministic 反馈源——LLM 自评不可靠,但 CI 通过/失败是 0/1 信号,可以直接作为 ground truth。Hashimoto 的 harness engineering 强调"能不能解决问题强相关于 agent 能不能验证自己的工作"。
让不可信代码(用户上传、LLM 生成)在受限环境中跑,防止破坏宿主系统。隔离强度从弱到强:
Agent 跑用户/LLM 生成代码必须沙箱,并叠加纵深防御:网络出口白名单 + 文件系统只读 + 时间/内存配额 + 不挂载 host 凭据。
来自煤矿用金丝雀检测毒气的典故。部署流程典型为:shadow(双跑不返回)→ 1% → 5% → 25% → 50% → 100%,每阶段观察核心指标无回归才推进。
对 LLM 应用:新 prompt / 新模型 / 新 agent harness 上线必走 canary,关键指标(解决率、CSAT、refusal 率、p99 延迟、单次成本)任何一个恶化 > 阈值就回滚。LLM 应用的"非确定性"特性让 canary 比传统软件更重要。
按 user_id hash 切流量保证一个用户始终进同一桶(避免体验跳变)。判定要素:
LLM 应用调 prompt / 换模型 / 改 RAG 都应过 A/B;只靠 offline eval 上线常翻车(线上流量分布与黄金集差异大)。
业务侧验收 Agent 是否上线最看的几个指标:
Agent 工程关注:把模型 / prompt / RAG 改动放进 A/B 看这些业务指标,而非只看离线 benchmark 分数。改动让 benchmark 涨但 GMV / CSAT 跌的情况非常常见。
Agent 自治走到关键节点时暂停等待人工:
设计原则:"Humans steer. Agents execute."(OpenAI Harness Engineering)。Agent 不是替代人,是放大人的判断——把人放在制定计划、设定约束、审核结果的位置,agent 处理执行。
Google SRE 体系定义的四个术语:
1 - SLO。SLO 99.9% 意味着 30 天有 43.2 分钟"预算"可以不达标,预算用完就冻结非必要发布。Agent 应用怎么用:
经验法则:SLO 不是越严越好——99.99% 比 99.9% 贵 5-10 倍,且大概率超过用户感知阈值。Google 建议"刚刚够用户不抱怨"的水位。
到期自动失效。常见用法:
经验换算:1000 英文单词 ≈ 1300 token;1000 汉字 ≈ 1500-2000 token。
为什么重要:context window、API 计费、推理速度都按 token 算。控制 token 数 = 控制成本和延迟。Anthropic / OpenAI / Google 各自的 tokenizer 不同,相同文本 token 数差 ±20% 很常见。
文本 → 神经网络 → 一个 768 / 1024 / 1536 / 3072 维的浮点数向量。同义词 / 同主题文本的向量在空间中距离近(cosine similarity 高)。
主要用途:
主流模型 2026:OpenAI text-embedding-3-large、Cohere v4、Voyage-3、BGE-M3(开源 SOTA,中英双语 + dense/sparse/multi-vector 三合一)。
包含 system prompt + 历史对话 + 用户输入 + 模型输出,所有都计算在内。2026 主流模型:
注意:宣称窗口 ≠ 有效窗口。RULER 基准显示多数模型在窗口 1/4 之外性能急剧下降(Lost in the Middle)。工程建议把"应当塞入 context"的阈值定在 8-32k,更长走 RAG 或层级摘要。
两个阶段瓶颈不同,调优策略也不同——prefill 优化靠并行 / FlashAttention,decode 优化靠 continuous batching / speculative decoding。
生成第 t 个 token 时需要前面所有 token 的 K/V 参与注意力计算。把它们缓存下来避免每次重算,是 LLM 推理的最基础优化。
显存占用:2 × num_layers × num_heads × head_dim × seq_len × batch × bytes_per_elem。70B 模型上 128k 上下文的 KV cache 可达数十 GB,远超模型权重本身。
进阶优化:
GPT 类 decoder-only 模型的生成方式:P(x_t | x_1, ..., x_{t-1})。每生成一个 token 都要跑一次完整 forward(虽然能复用 KV cache),所以输出长度直接决定延迟。
对比:BERT 是非自回归(masked LM,一次预测所有 mask 位置),扩散模型(diffusion)也是非自回归(一次去噪整段)。
自回归的代价催生了大量加速技术:speculative decoding、parallel decoding、Medusa、EAGLE 等。
decoder 最后一层输出 [vocab_size] 维的 logit 向量;过 softmax 后得到下一个 token 的概率分布。
工程上能拿到 logit(或 top-k logprob)的场景:
注意:OpenAI / Anthropic 商用 API 默认只返回采样结果,需显式开 logprobs 选项。
P(token) ∝ exp(logit / T):
何时调高:Self-Consistency 需要多样路径、creative writing、brainstorm。
何时调低:代码生成、数学推理、严格格式输出,T=0.1-0.3。
陷阱:T=0 不完全等同 deterministic——浮点 GPU 算子的非确定性 + 并发调度可能让相同 prompt 的输出仍有微差。
Xiao et al. 2023 发现:长序列推理时,靠后的 token 往往把不成比例多的注意力分给了序列最前面的几个 token(即使它们语义无关)——这些 token 成为"sink",吸收掉 softmax 必须分配的归一化质量。
工程意义:
LayerNorm:y = (x - μ) / σ * g + b,沿 hidden 维度求均值方差。与 batch 无关,天然支持变长序列与单条推理——这是 Transformer 选 LayerNorm 而非 BatchNorm 的原因。
RMSNorm(Zhang & Sennrich 2019):y = x / sqrt(mean(x²)+ε) * g,去掉减均值和 bias。Llama / PaLM / Mistral 等现代 LLM 几乎都改用 RMSNorm,省 7-64% 归一化耗时且效果不降。
Pre-LN vs Post-LN:LN 在残差前做(Pre-LN)训练比放残差后(Post-LN)稳定,可去掉 warmup,GPT-2 起几乎统一用 Pre-LN。
Su et al. 2021。把位置 m 表示为旋转矩阵 R_m 作用在 Q/K 上,使得 <R_m·q, R_n·k> = f(q, k, m-n)——注意力得分只依赖相对距离。
优点:(1) 无额外参数;(2) 天然编码相对位置;(3) 可与线性注意力兼容。已成 Llama / Qwen / Mistral 等绝大多数现代 LLM 的位置编码方案。
外推问题:纯外推 2k→32k 会崩——高频分量旋转角度落入未见区域。缓解:
RoPE 纯外推会崩——高频分量在训练上下文外旋转角度落入未见区域。两种工程化方案:
主流应用:
经验数字:YaRN 在 4× 上下文扩展(2k→8k 或 32k→128k)几乎无损;8× 以上仍有性能下降。极致长上下文(1M+)通常需要重训而非仅靠 YaRN。
标准 multi-head attention:H 个头各有独立 Q/K/V。
收益:KV cache 减小到 1/8 ~ 1/H,推理吞吐显著提升,效果几乎无损。Llama-2 70B / Llama-3 / Mistral / Qwen2 等都用 GQA。
把传统 dense FFN 换成 N 个并行的 expert FFN + 一个 router。每个 token 通过 router 选 top-k 个 expert(k 通常 1-2),只激活这部分 expert 计算。
优点:参数量大、算力省。Mixtral 8x7B 总参数 47B,激活参数仅 13B;DeepSeek-V3 671B 总参数,激活仅 37B。同等推理成本下 capacity 远超 dense 模型。
挑战:(1) 训练时负载均衡(防一两个 expert 被过度使用);(2) 显存占用按总参数计而非激活参数;(3) 通信开销大(expert parallelism)。
单头注意力对每对 token 只产生一个 attention 分布——一种"关系视角"。多头(h=8/32/64/128)让模型同时学多种关系——句法头关注短距离依赖,语义头关注共指、远程实体。
为什么单头加大维度不行:多头是 h 个低秩注意力的混合,表达能力严格更强;单头是一个高秩注意力,自由度反而少。
进阶变体:GQA / MQA 在 KV 侧减头省显存,Q 侧仍保多头。
Dao 2022。标准 attention 显存 O(N²)(要存 N×N 的 attention matrix),长序列瓶颈。FlashAttention 把 Q/K/V 分块加载到 GPU SRAM 计算,不写出完整 attention matrix,显存降到 O(N),速度也快——attention 是 memory-bound,少读 HBM 就快。
演进:
Kwon et al. 2023。解决传统推理 KV cache 的三类碎片问题:
机制:KV cache 切成固定大小 block(如 16 token),每个序列维护 block table(逻辑→物理映射)。显存利用率从 ~20% 提到 >96%;同 prompt 多采样共享前缀 block;配合 continuous batching 吞吐相对 HuggingFace TGI 提升 2-4×,相对 FasterTransformer 24×。
2023 年起的事实标准开源推理服务器。核心特性:
对比:TGI(HuggingFace)、TensorRT-LLM(NVIDIA,私有更快)、SGLang(前缀复用更彻底)、LMDeploy(OpenCompass 出品)。
也叫 in-flight batching,Yu et al. ORCA 2022 提出。对比 static batching(等齐 batch 再一起跑,长短请求混在一起时 GPU 利用率经常 <30%),continuous batching:
vLLM 数据:吞吐相比 static 提升 5-23×。已成所有现代推理引擎的默认。
Leviathan et al. 2023。流程:
数学上保证输出分布与原模型完全一致(rejection sampling)。
收益条件:(1) draft 与 target 分布相似(接受率 >60%);(2) 大模型受 memory bandwidth 限制,并行验证不增延迟。代码生成接受率 70-90%,开放生成 30-50%。变体:EAGLE-2/3、Medusa、Llama 3.1 self-speculative。
KV cache 是单 request 内复用;prefix caching 是跨 request 复用——多个 request 共享 system prompt / few-shot / agent 历史时,首次计算后缓存这部分 KV,后续 request 直接命中跳过 prefill。
效果:agent / RAG / 多轮对话场景,system prompt 通常 1-4k token、几乎所有请求共享,TTFT 可下降 10-100×。
实现:vLLM --enable-prefix-caching、SGLang RadixAttention(用 radix tree 自动管理所有历史前缀)、Anthropic prompt caching API(5min TTL,cached 部分 0.1× 价格)。
主要由 prefill 决定(处理 input 所有 token)。计费、监控的核心指标之一。
降低 TTFT 的手段:
伴生指标:TBT(time between tokens,单 token 间隔)— 由 decode 决定。
混合精度训练:权重和梯度用 BF16/FP16,optimizer state 仍用 FP32。
部署阶段把权重量化到低 bit 整数,推理时反量化回浮点计算。
INT8 / INT4 量化通常需要校准集(128-512 样本),AWQ 更智能(保护 1% salient 通道)。极致显存场景再用 GGUF(llama.cpp 格式)+ 3-bit / 2-bit 量化跑手机端。
Lin et al. 2023。核心洞察:只需保护 ~1% 的"重要权重通道"(由激活幅值识别)即可保住精度。对这些通道按 per-channel scale 放大再量化。
对比 GPTQ:实现更简单,Llama-2 上困惑度更低,已成 vLLM / TensorRT-LLM 默认。
Frantar 2022。用 OBQ 启发的逐层最小化量化误差,需要少量校准集(128 样本)。优点:早、生态全(exllama / vllm / TGI 都支持);缺点:对激活分布敏感,重要通道可能被压坏。
2026 部署选型:H100/H200 → FP8;A100/3090 → AWQ INT4;手机/边缘 → INT4 + GGUF。
最基础的指令微调方式:把 (输入, 期望输出) 对当做监督学习样本,cross-entropy loss 教模型学指令跟随。
经验数据量:
LIMA 论文:1000 条精选样本即可让 65B base 接近 GPT-4 对话质量——质量 >> 数量。
Hu et al. 2021。把权重更新分解为两个低秩矩阵 ΔW = BA(r=8/16/64),只训练这两个矩阵,可训参数减少 100-10000×。
显存:
优点:可训参数少 / 多个 adapter 可热切换 / 缓解 灾难性遗忘。
Dettmers et al. 2023。三项关键:
65B 模型 QLoRA 约 33GB,单 A100-48G 或双 RTX 3090 可跑。代价:训练慢 30-40%(反量化开销)。
三步走:(1) SFT 训出 base policy;(2) 人类标注 (chosen, rejected) 偏好对训出 Reward Model;(3) 用 RM 给 policy 输出打分,PPO/RLOO/REINFORCE 等算法更新 policy。
InstructGPT、ChatGPT 让 RLHF 出圈。三大痛点:
RLHF 第二步训出。输入:(prompt, response),输出:一个 scalar reward。训练 loss 是 Bradley-Terry:让 RM 在 (chosen, rejected) 对上给 chosen 更高分。
常见弱点:
Rafailov et al. 2023。证明:在 Bradley-Terry 偏好模型 + KL 约束下,最优 policy 有闭式解,可直接用偏好对 (chosen, rejected) 做监督式损失:
L_DPO = -log σ(β(log π(y_w)/π_ref(y_w) - log π(y_l)/π_ref(y_l)))
优势:(1) 无 RM / 无在线采样 / 无 critic,仅 policy + ref 两个模型;(2) 用 SFT 同样的训练栈;(3) 超参稳定。
劣势:严重依赖偏好数据质量;容易过拟合 chosen 的表面模式;reward hacking 风险大。
Llama-3、Qwen2 后训练主路径都是 DPO 或其变种(IPO、KTO、SimPO)。
Schulman 2017。Actor 学策略,critic 学 value function 估计 advantage,clip 限制每步策略更新幅度防崩。
RLHF 中需同时载入 actor / ref / critic / reward 四个模型,显存 ≥4× 单模型。超参敏感(KL 系数、clip ratio、advantage 归一化),训练不稳定。
催生了 DPO(去 RL)、GRPO(去 critic)、RLOO(用平均 reward 当 baseline)等简化方案。
DeepSeek-Math 2024 提出,R1 验证。核心创新:去掉 critic(value 网络),对同一 prompt 采样 G 个 response(典型 G=64),用组内 reward 的均值/标准差做 advantage 归一化:A_i = (r_i - mean(r)) / std(r),再做 PPO-like 的 clipped objective + KL 正则。
效果:
在数学、代码、形式逻辑等可自动验证的任务上,直接用程序判定 reward:答案匹配、单测通过、定理证明器验证。
优势:
DeepSeek-R1、DAPO(ByteDance 开源 SOTA)都属此类。局限:仅适用可验证任务,开放对话仍需 RLHF / DPO。
机制:参数被新任务 loss 拉走,原本编码通用知识的方向被覆盖。
缓解组合(生产推荐):
进阶:EWC(按 Fisher 信息加权 L2 正则)、Model Souping(微调模型与原模型权重平均)、MoE 路由扩展。
Wei et al. 2022。最简形式:"Let's think step by step"(Kojima 2022 zero-shot CoT)。
为什么有效:(1) 增加有效 compute(更多 forward step);(2) 把"系统 1"直觉答题转成"系统 2"分步推理;(3) 暴露错误推理便于 self-consistency 投票纠正。
是涌现能力,<10B 模型几乎无效。Long CoT(R1 / o1 用 RL 训出,含回溯/自我验证,数千 token 长)是 2025 的新范式。
Yao et al. 2023。CoT 是线性单链,错了无法回头;ToT 每步生成多个候选 thought,LLM 自评估状态价值(promising / sure / impossible),BFS/DFS 展开可回溯剪枝。
Game of 24 上 GPT-4 CoT 4% vs ToT 74%。代价:LLM 调用数从 1 涨到 50-200。
适合:解空间需显式搜索(puzzle、规划、定理证明),中间状态可评估。不适合:闲聊、摘要、翻译。
Yao et al. 2022。结构 Thought → Action → Observation 循环:模型先 "Thought: 我需要查 X",输出 "Action: search[X]",工具结果作为 "Observation: ..." 喂回 prompt,再下一轮 Thought。
三大效果:
是现代 agent 框架(Claude tool use、OpenAI function calling、LangChain、AutoGPT)的概念原型。
Shinn et al. 2023。Agent 在一次任务失败后(由外部 verifier 给二元 reward),用 LLM 把失败原因总结成自然语言 lesson 存入 episodic memory,下一次任务时把 lesson 加进 prompt 影响行为。
vs Self-Refine:
HumanEval 上 GPT-4 Reflexion 91%,超过 GPT-4 baseline 80%。
Madaan et al. 2023。在一个 trajectory 里循环 N 轮,无外部 reward、无跨任务记忆。7 个任务平均提升 20%。
陷阱:弱模型自评不准,可能越改越差。生产常组合 Self-Refine(局内)+ Reflexion(跨局)。
Wang et al. 2022。temperature>0 采样 N 条 CoT 路径,对最终答案投票。GSM8K 上比 greedy CoT 提升 ~17 个百分点(PaLM 55%→74%)。
收益大场景:(1) 答案空间离散(数字、选择题);(2) 模型错误率 <50%;(3) 推理路径多样(temperature 0.7-1.0)。代价:N×(典型 N=5-40),开放生成不适用。
何时 few-shot:(1) 任务格式新颖/输出结构复杂(JSON schema、特定 markdown);(2) 分类任务标签多。
何时 zero-shot:通用任务现代模型已饱和(摘要、翻译、QA),加 example 反而引入偏差。
陷阱:example 顺序影响大(recency bias);偶然规律会被学走;example 多了 Lost in the Middle。建议 ≤8 条。
标准 pipeline = Ingestion + Retrieval + Generation:
每段都有瓶颈:chunking 切大小、embedding 选型、召回率不足、context 顺序、模型不忠于 context。生产 RAG ≠ "embedding + 向量库 + LLM"——是一个工程系统。
策略:
Okapi BM25。文档与 query 的相关性按 Σ IDF(qi) · f(qi,d) · (k+1) / (f + k·(1-b+b·|d|/avgdl)) 计算。强项:精确词命中、稀有词高权重、专有名词、数字。短板:同义词不通("医生" vs "doctor")。
与 dense embedding 互补——hybrid search 把两者融合,召回率比单 dense 提升 5-15 个百分点。
dense embedding 擅长语义近似,BM25 擅长精确词匹配,两者互补。
融合方法:
score(d) = Σ 1/(k + rank_i(d)),k=60。生产首选,无需归一化两路分数α·dense + (1-α)·bm25,需要调 α 且分数归一化Anthropic Contextual Retrieval 实验:单 embedding → +contextual embedding → +BM25 → +rerank,失败率 5.7% → 4.0% → 3.7% → 1.9%。
Bi-encoder(embedding):query / doc 分别编码再 cosine 比对,快但无交互。
Cross-encoder(reranker):query + doc 拼接喂 transformer,每层 self-attention 交互,相关性建模能力强 20-40%(NDCG@10),慢 100×。
生产标配:bi-encoder 召回 top-100 → cross-encoder rerank 到 top-10 → 喂 LLM。
主流:Cohere Rerank v3/v4、BGE-reranker-v2-m3(开源 SOTA 中英)、Jina Reranker v2、Mixedbread。
陷阱:召回 top-100 里没有相关文档,rerank 也救不了——reranker 锦上添花,不能替代召回。
2026 主流 embedding 模型对比:
选型框架:
关键陷阱:
主流:
ANN 算法:HNSW(最常见)、IVF、ScaNN(Google)。索引时间 vs 检索精度 vs 显存有 trade-off。
朴素 RAG 在多文档跨实体推理、召回质量不稳、多跳查询场景下都会力不从心。四个常见进阶方案:
实战选择:
Es et al. 2023。四大指标:
生产阈值:4 个指标都 ≥0.7 算合格;Faithfulness < 0.7 优先修;Context Recall < 0.7 调 retriever。
Mitchell Hashimoto 2026 命名:"anytime you find an agent makes a mistake, take the time to engineer a solution such that the agent never makes that mistake again."
不是模型微调,而是工程化环境让模型物理上无法以同样方式再犯错。
两条法则:
OpenAI 公式:Agent = Model + Harness;"Humans steer. Agents execute."
2024-2026 主流框架对比:
经验:先用 SDK 直调写原型;workflow 模式(routing / parallelization / orchestrator-workers)成熟后再考虑 LangGraph;纯 RAG 场景考虑 LlamaIndex;避免一上来就 LangChain "全家桶"。
2024-11 推出,2025-Q4 转入独立 Steering Committee(Anthropic / Block / OpenAI / Microsoft)。三种核心原语:
解决"每接一个新工具就要写一遍 adapter"的 N×M 问题。2026 年增速最快的单一技能,97M+ 月下载,已是 Anthropic Applied AI Engineer JD 显式必备。
模型输出 {"name": "search", "arguments": {"query": "..."}} JSON,runtime 解析后真实执行函数,结果回喂模型。Anthropic Tool Use API、OpenAI function calling 都是同思路。
设计原则(Anthropic 实测:"agent 性能正比于工具描述清晰度"):
Anthropic 2024-Q4 推出 Computer Use。流程:截屏 → LLM 看图 + 推理 → 输出鼠标键盘动作(click X,Y / type text / scroll)→ 系统执行 → 再截屏循环。
Browser Use(开源框架)类似但限于浏览器,基于 Playwright + DOM 增强(把可点击元素加序号叠加到截图)。
实用场景:无 API 网站自动化、桌面软件自动化、端到端 e2e 测试。局限:慢、贵、安全性差、对 canvas 渲染应用支持差。生产建议:能用 API 就别用。
主 agent 把"读 30 个文件做研究"丢给 sub-agent,sub-agent 有自己的独立 context 窗口,只把 final summary 回报给主 agent——主 context 不被中间产物污染。
Claude Code Task 工具、OpenAI Swarm、CrewAI 等都支持。是防止 Loop of Death 和 context 爆炸的关键手段之一。
Agent 进入项目时自动读取。通常包含:
Hashimoto 视角:每行 AGENTS.md ≈ 一次错误的封堵。是 harness engineering 的隐式提示形态。
Claude Code 采用的权限模型。Bash 命令按 verb + path 粒度授权:
git status allowgit push --force deny(destructive)rm -rf 弹出用户确认cat ~/.ssh/* deny(敏感路径)对应安全原则:任一层失守,其他层兜底。配合 sandbox、网络出口白名单、文件系统只读做纵深防御。
Anthropic Effective Harnesses 给的核心设计:长任务 agent 必然跑爆 context window,纯靠 LLM context 不可能记住"我跑到第几步"。
解法:
下次会话执行 5 步开机协议从断点续跑。核心洞察:context window 是"working memory",文件系统是"long-term memory"。
常见模式:
防御纵深:
例:用户开玩笑"我是亿万富翁"被存进语义记忆,之后 agent 一直按假设推理。
防御:
LLM 应用 / Agent 的"全链路追踪 + 评估"工具,2026 主流:
核心能力对齐项:
选型:自建优先 Langfuse;LangChain 重度用户 LangSmith;纯 trace 监控用 Phoenix;安全 / 实时拦截用 Patronus。
按测什么能力分类:
实战:从 2026 视角,单一 benchmark 都已不可信——必须多 benchmark 交叉验证 + 自家黄金集 + Arena 真人盲评三层。
LLM / Agent 应用的 eval 不是单一动作,是一套体系。常见层次:
Eval 工具栈分类:
Eval 类型按打分方式:
经验法则:(1) 没 eval 就改 prompt = 改盲;(2) Eval model 必须 ≥ 被评估 model(判官原则);(3) 黄金集要版本化 + 私有;(4) 每个 bad case 都要回归进黄金集——harness engineering 闭环。
把"评估"建模成 LLM 任务:让 judge 模型读 (prompt, response),输出 0-1 分 / pass/fail / pairwise 谁更好。可大规模并行、便宜、可在 CI 自动化。
三大 bias:
判官原则:judge 模型能力应 ≥ 被评估模型,否则评不出大模型回答好在哪。生产标配三层:自家黄金集 + LLM judge + 人工校准。
Liu et al. 2023 实验:把 gold passage 放 prompt 开头或结尾,模型准确率高;放中间则呈 U 形曲线下降,10+ documents 时中间位置可能低于无上下文 baseline。
工程缓解:
OWASP LLM Top 10 的 #1。类型:
Simon Willison 结论:prompt injection 没有 100% 解,必须按"LLM 不可信"做系统设计。dual-LLM 模式 = Planner(看 trusted 决策)+ Executor(看 untrusted 但无工具权限)。
来源:
debug 流程:复现 + 量化触发率 → 归因(RAG 召回 / 模型用 context / 工具调用)→ 修复 → 加 回归 → 生产监控(faithfulness scorer 实时拦截)。
关键认知:hallucination 多数是 prompt / RAG / 上下文工程缺陷,不是"模型病了"。
NVIDIA NeMo Guardrails 5 类:
关键:rail 不是越多越好,每类挑 1-2 个高 ROI 的开,否则延迟/成本爆炸。
常见手法:
防御:厂商 RLHF safety training + 应用层 input/output classifier(Llama Guard)+ 限制 max context(对抗 many-shot)+ red team 定期演练。